

Varför alla organisationer bör investera i prediktiv AI
Företag häller ut miljontals kronor i generativ AI – chattbotar, copiloter, ”agenter” – samtidigt som de i det tysta ignorerar den andra halvan av AI-stacken, som har levererat mätbart värde i årtionden. Prediktiv AI skriver inte poesi. Den förutsäger vilka som kommer att lämna, vilken transaktion som är bedräglig och vilken kund som är värd att kontakta. Den beräknar sannolikheter och hjälper dig att agera utifrån dem i stor skala. Inte glamoröst. Bara effektivt.
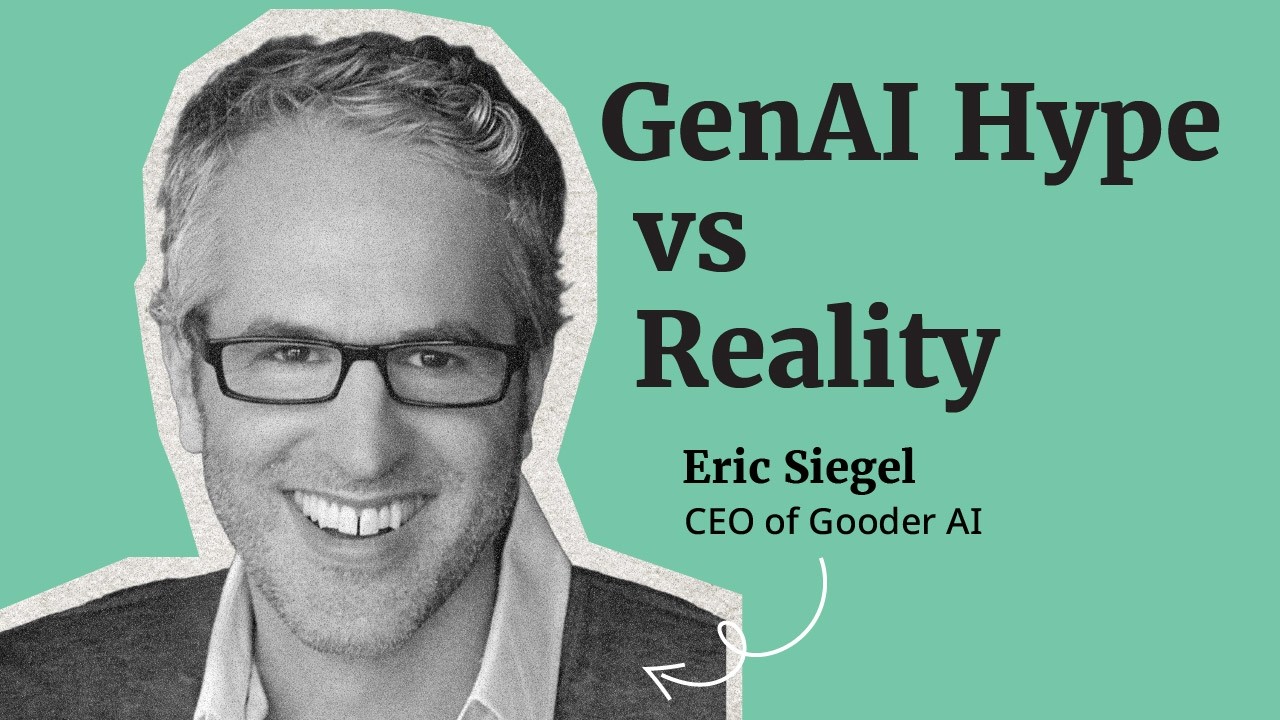
I det här samtalet framför Eric Siegel – författare till The AI Playbook och grundare av Machine Learning Week – ett omstörtande påstående: de flesta organisationer bör investera minst lika mycket i prediktiv AI som i generativ AI. Problemet är inte matematiken. Det är gapet mellan teknik och verksamhet. Företag hyllar modeller som värde. Men modellen är inte värdet. Det är att agera utifrån förutsägelser som skapar värdet.
Det här får du lära dig
- Varför prediktiv AI är de ”bortglömda 50 procenten” av AI-stacken
- Den avgörande skillnaden mellan tekniska mått och verksamhetsmått
- Varför 95 procents träffsäkerhet ändå kan göra ditt AI-system värdelöst
- Hur prediktiv AI kan fungera som ett tillförlitligt lager för generativ AI
- BizML-ramverket i sex steg – och varför de flesta företag hoppar över verksamhetsdelen
- Vad företagsledare behöver förstå om sannolikheter (och varför det inte är raketforskning)
Viktigaste slutsatserna
- Generativ AI är hetare. Prediktiv AI är ofta mer autonom.
Generativ AI känns mänsklig. Därför får den uppmärksamhet. Men den kräver vanligtvis en människa i loopen. Prediktiv AI automatiserar däremot i det tysta beslut i stor skala – stoppar bedrägerier, riktar marknadsföring och prioriterar inspektioner – utan stora åthävor. - Hajpen snedvrider investeringsbesluten.
Prediktiv och generativ AI löser olika problem. De borde inte konkurrera mer än ett vattenland och en skidort. Men det gör de – om budget, talanger och uppmärksamhet. Och den obalansen kostar organisationer verkligt värde. - En framgångsgrad på 95 procent kan innebära 0 procents användbarhet.
Om ett generativt AI-system gör kritiska fel 5 procent av tiden kanske det aldrig tas i bruk. Det är där prediktiv AI kommer in – genom att flagga högriskfall och skicka dem vidare till människor. Fånga upp de flesta av de riskfyllda 5 procenten, så blir plötsligt 85 procents automatisering genomförbar. - Modellen är inte värdet. Det är den operativa integrationen som skapar värdet.
Dataforskare bygger modeller. Organisationer jublar. Sedan … händer ingenting. Eftersom det är implementeringen – att faktiskt integrera förutsägelser i arbetsflöden – som skapar värde. Ingen operativ förändring, ingen förbättring av verksamheten. - Tekniska mått betalar inte räkningarna.
Area under kurvan. Precision. Återkallelse. Imponerande, ja. Men de besvarar inte den enda fråga som spelar roll: Hur mycket pengar kommer vi att tjäna eller spara om vi använder det här?
Verksamhetsmått – vinst, besparingar och påverkan på nyckeltal – måste vara en del av projektet från början, inte något man tänker på i efterhand. - Prediktiv AI handlar om sannolikheter, inte magi.
Inga kristallkulor. Bara bättre odds. Ett tal mellan 0 och 100 för varje fall – vem som sannolikt kommer att lämna, köpa eller begå bedrägeri. Den sannolikheten gör att du kan prioritera begränsade resurser. I stor skala ackumuleras dessa små beslut. - De flesta företag hoppar över projektets verksamhetsdel.
Erics BizML-ramverk beskriver sex steg. Datateam utbildas i de tre sista:- Förbered data
- Träna modellen
- Implementera modellen
Men de tre första – att definiera vad som ska förutsägas, hur väl det ska göras och vad man ska göra åt det – kräver ett djupt samarbete med verksamheten. Hoppa över dem, så förblir implementeringsgraden bedrövlig.
- Det här är ett verksamhetsinitiativ som råkar använda maskininlärning.
Prediktiv AI är inte en teknisk installation. Det är en operativ förändring. Det kräver intressenter som förstår tillräckligt för att delta – inte för att byta tändstift, utan för att köra bilen.
Kapitel
- 00:00 – De bortglömda 50 procenten
- 02:12 – Varför GenAI fångar uppmärksamheten
- 05:47 – Agenter och tillförlitlighet
- 10:15 – Varför driftsättning misslyckas
- 17:56 – Den organisatoriska förändringen
- 21:06 – Hybrid-AI i praktiken
- 25:04 – Sannolikheternas kraft
- 29:14 – BizML-ramverket
- 32:43 – Jaga inte det luddiga
Möt vår gäst

Eric Siegel, Ph.D., är en bästsäljande författare, konsult och expert på maskininlärning, känd för att göra prediktiv analys och AI tillgängligt för både affärs- och teknikmålgrupper. Han har skrivit de hyllade böckerna Prediktiv analys: Kraften i att förutsäga vem som kommer att klicka, köpa, ljuga eller dö och AI-handboken: Bemästra den sällsynta konsten att driftsätta maskininlärning och är grundare av den långvariga konferensserien Predictive Analytics World. Eric är tidigare professor vid Columbia University och UVA Darden och är även vd för Gooder AI, exekutiv redaktör för Tidskriften för maskininlärning samt en efterfrågad huvudtalare som hjälper organisationer att överbrygga klyftan mellan datavetenskap och verklig påverkan.
Relaterade länkar:
- Gå med i People Managing People-communityn
- Prenumerera på nyhetsbrevet för att få våra senaste artiklar och poddar
- Ta en titt på sponsorn för det här avsnittet: Deel
- Kom i kontakt med Eric:
- Ta en titt på Erics bok: AI-handboken
Relaterade artiklar och poddar:
David Rice: Företag investerar miljoner i generativ AI. De bygger agenter och jagar hypen. Och ofta ignorerar de den andra halvan av AI-stacken, alltså den del som faktiskt levererar mätbart affärsvärde. Prediktiv AI är inte sexig. Den skriver inte dikter eller genererar bilder. Den förutsäger bara vem som kommer att klicka och vem som kommer att köpa. Den riktar din marknadsföring. Den upptäcker bedrägerier innan de inträffar och automatiserar beslut i stor skala utan en människa i loopen. Om du lämnar den outnyttjad beror det ofta på att den inte verkar lika mänsklig.
Dagens gäst är Eric Siegel, författare till The AI Playbook och grundare av Machine Learning Week. Enligt honom bör de flesta organisationer investera minst lika mycket i prediktiv AI som i generativ AI, men alldeles för mycket syre sugs ut ur rummet av hypen kring generativ AI, och det är en förlust för alla. Här är problemet han ständigt ser. Företag behandlar prediktiv AI som ett datavetenskapligt projekt.
De skickar iväg datavetaren för att bygga en modell, firar när den är klar och kallar sedan detta för värde. Men modellen är inte värdet. Att agera utifrån förutsägelserna är värdet. Operativ integrering är värdet. Och det kräver ett djupt samarbete med affärens intressenter genom sex steg som Eric kommer att beskriva, inte bara tre tekniska steg.
De flesta företag hoppar helt över stegen på affärssidan. De hoppar över att definiera vad som ska förutsägas och vad som ska göras åt det. De hoppar över operativ integrering. Och sedan undrar de varför deras AI-investeringar inte ger resultat. Så i dag ska vi gå igenom varför prediktiv AI är mindre sexig men mer autonom än generativ AI.
Hur prediktiv AI kommer att bli det tillförlitlighetslager som faktiskt gör generativ AI användbar. De sex stegen i Biz ML-ramverket och vilka tre som affärens intressenter sannolikt hoppar över. Varför en träffsäkerhet på 95 procent låter imponerande men gör ditt system värdelöst. Och vad företagsledare behöver förstå om sannolikheter. Oroa dig inte, det är ingen raketforskning.
Jag heter David Rice. Det här är People Managing People. Och om du har jagat generativ AI samtidigt som du lämnat prediktiv AI outnyttjad visar det här samtalet exakt vad du missar. Då kör vi.
Eric, välkommen! Det är roligt att ha dig med i programmet i dag.
Eric Siegel: Tack, David. Fantastiskt att vara här.
David Rice: Generativ AI får mycket av rampljuset, men du har kallat prediktiv AI för den bortglömda halvan av AI-stacken, eller hur? Den är ändå avgörande för verkligt affärsvärde. Jag är nyfiken på varför du tror att organisationer är så mycket mer entusiastiska över generativa modeller och vad som förbises när dessa prediktiva system hamnar i bakgrunden i människors tankar.
Eric Siegel: Ja, jag gillar hur du uttrycker det. Prediktiv AI är äldre, men inte gammaldags. Det mesta av dess värde är fortfarande i stort sett outnyttjat. Det är den andra, den ursprungliga AI:n. På sätt och vis är det vad de flesta menade med AI innan chattGPT och andra generativa AI-lösningar kom för några år sedan. Den lär sig från data för att förutsäga, så att man kan rikta in sig på och förbättra storskalig verksamhet. Förutsäg vem som kommer att klicka, köpa, ljuga eller dö, begå bedrägeri eller vilket annat resultat eller beteende som helst som kan vara värdefullt för en organisation som bedriver storskalig verksamhet. Din fråga är varför generativ AI får så mycket av rampljuset.
Svaret är egentligen enkelt. Den är mycket sexigare och mycket lättare att använda. Inget av detta innebär att den nödvändigtvis är mer värdefull, och jag ska bemöta båda dessa saker. Låt mig göra ett svepande påstående som verkligen är omstörtande i dagens kultur, där man så starkt fokuserar på generativ AI och en viss mängd hype kring dess potentiella värde.
Även om den är oerhört värdefull, och jag inte kritiserar tekniken – jag är imponerad av den – kritiserar jag en del av berättelserna och hypen kring den. Men här kommer det omstörtande påståendet: de flesta organisationer bör investera minst lika mycket i prediktiv AI som i generativ AI, och de två löser olika problem och bör inte konkurrera mer än en vattenpark och en skidort.
De konkurrerar i hög grad om uppmärksamhet, datavetarnas tid och resurser. Så det blir tyvärr delvis ett nollsummespel. Till vår nackdel sugs alldeles för mycket syre ut ur rummet av generativ AI. Det är oproportionerligt, eller hur? Det är en förlust för alla. Prediktiv AI kan rikta in marknadsföring genom att förutsäga vem som kommer att köpa, rikta in bedrägeridetektering genom att förutsäga vilken transaktion som kommer att visa sig vara bedräglig.
Och mer specifikt avgöra vilken transaktion som ska blockeras, hållas inne eller granskas. När man har storskalig verksamhet är resurserna alltid begränsade. Affärer är ett sifferspel. Vi har ingen magisk kristallkula, men vi kan förbättra oddsen genom att förutsäga bättre än genom att gissa. Det är namnet på det sifferspel man spelar med prediktiv AI.
Det vill säga, den beräknar sannolikheter utifrån historik. Sannolikhet är inte världens sexigaste samtalsämne, men om du är intresserad av värde – om du är intresserad av att förbättra din befintliga storskaliga verksamhet – är det här du vanligtvis vänder dig. Sexigheten hos generativ AI kommer från hur mänsklig den verkar och hur väl den passar in i den långsiktiga berättelsen om AI.
Ända sedan begreppet kom på femtiotalet, alltså 1950-talet, och naturligtvis alla de oerhört underhållande filmerna och liknande. Den verkar så mänsklig, och den är anmärkningsvärd. Det är inte helt orelaterat till dess potentiella värde i alla användningsområden där den kan fungera som tankepartner och skapa första utkast, första kodutkast och allt det som den gör så imponerande. För de allra flesta användningsområden behöver man dock fortfarande ha en människa i loopen.
Ironiskt nog gör detta att den tillämpas på sådant som människor normalt skulle göra och där man är mindre tolerant mot fel. Prediktiv AI verkar däremot mindre mänsklig men är faktiskt mer potentiellt autonom, eftersom den automatiskt kan besluta vilken kreditkortstransaktion som ska blockeras eftersom den kan vara bedräglig, till exempel.
Det var min lilla monolog om skillnaden mellan de två områdena.
David Rice: Ingen fara. Det roliga är att det är som personen i kompisgänget som ordnar alla fantastiska middagar, men ingen tänker på personen som en matälskare eftersom deras Instagram inte ser ut som Food Network.
Men det är intressant, för som du säger har det funnits länge. Jag tror att många företag, särskilt på företagsnivå, har arbetat med de här systemen ett tag. Jag pratade med en gäst nyligen och vi diskuterade att om man har infört några av de här systemen och gjort arbetet, så kommer den agentrevolution som är på väg kanske inte nödvändigtvis att vara ens sak, eftersom mycket av det här redan är automatiserat.
Eric Siegel: Jag är oroad över terminologin kring agentisk AI och AI-agenter. Jag har skrivit ett par artiklar i Forbes där jag säger att jag tycker att begreppet oftast är missvisande och ohjälpsamt.
Det är ett hypebegrepp. Det antyder ingen särskild ny typ av teknik. Det antyder bara avsikten, nämligen att automatisera ytterligare, och det är naturligtvis en självklar avsikt. Det är ju det vi vill göra. Det är därför vi bygger maskiner: för att göra sådant som annars skulle behöva utföras av en person.
Att vi klistrar ordet agentisk på något betyder alltså inte att det finns något nytt. Det handlar snarare om relativt självklara användningsområden som man skulle försöka genomföra med generativ AI, men man når snabbt en ambitionsnivå och avsikt för projektet som ligger utanför dess förmåga att vara autonomt utan en människa i loopen.
Det leder till en huvudpunkt som jag har börjat tala mycket om: var de två universumen kolliderar, där prediktiv AI och generativ AI verkligen behöver varandra. Jag tror att prediktiv AI:s nästa stora användningsområde blir att fungera som tillförlitlighetslager för generativ AI.
I takt med att vi alla snabbt får dessa underbara ambitioner för generativ AI, oavsett om vi kallar det en agent eller använder andra ord, har vi idén att den ska fungera som kundtjänstagent. Den ska interagera direkt med konsumenter kring ett relativt stort antal ämnen eller till och med kunna genomföra transaktioner.
Idén om att göra detta helt automatiskt blir snabbt ohanterlig, beroende på exakt vad systemet ska kunna göra. Det når snabbt en punkt där det kanske gör ett kritiskt fel fem procent av gångerna. Det lämnar ut information som inte ska lämnas ut eller genomför en transaktion som det verkligen inte borde genomföra. Det finns en miljon olika saker som kan gå fel. Om det fungerar rätt 95 procent av gångerna är det otroligt, imponerande och utan motstycke – något vi inte hade kunnat föreställa oss för några år sedan. Men hela systemet saknar värde. Det är inte användbart och kommer inte att tas i drift.
Felfrekvensen på fem procent är för hög. Hur hanterar vi det? Vi kan sitta och vänta på att alla hörn ska rundas av och att tekniken ska förbättras, men det är mycket svårare än vi inser. Skillnaden mellan vad generativ AI och människor kan göra ryms inom de där fem procenten, eller vad det nu blir beroende på uppgiften.
Skillnaden mellan vad generativ AI kan göra och vad människor kan göra kommer bara att bli allt tydligare. Förbättringarna ger avtagande avkastning, men vi kan förverkliga en stor del av det djärva löftet om autonomi om vi lägger till ett prediktivt lager. Vi kan använda prediktiv AI, prediktiv analys eller maskininlärning för företag – kalla det vad du vill – och lära oss av en mängd exempel hur man automatiskt flaggar de fall som sannolikt kommer att uppvisa ett problem.
Det kan vara fall eller situationer, interaktioner med slutkonsumenten eller vad systemet nu förväntas göra. Sedan styr man automatiskt de mest riskfyllda fallen vidare till den dyrare människan i loopen.
Till exempel de 15 procent mest riskfyllda interaktionerna med slutkonsumenter för en chattbot. Då pausas interaktionen och en människa kommer in. Personen ändrar eller ingriper vid behov. Vi vet inte exakt vilka 15 procent som innehåller de fem procenten fel. Vi har ingen magisk kristallkula för något prediktivt användningsområde, inte heller detta.
Men om vi gör det oftare än problemen uppstår – säg att vi granskar 15 procent för att försöka hitta de fem procenten – kan det räcka för att fånga majoriteten av dem. Kanske blir nettoresultatet en felfrekvens på en procent, vilket beroende på användningsområde och affärskontext kan göra systemet användbart. Då har vi förverkligat 85 procent av det djärva löftet om autonomi, vilket är mycket bättre än de noll procent vi förverkligar när systemet inte kan tas i drift.
David Rice: Du nämnde maskinlagret ovanpå, och jag är nyfiken eftersom du nyligen har kommit ut med en ny bok. Den heter The AI Playbook. Berätta om den. Jag tyckte att undertiteln var intressant: att bemästra den sällsynta konsten att driftsätta maskininlärning.
Varför är det så sällsynt? Det är där jag vill börja.
Eric Siegel: Ja, det är en obekväm sanning. Driftsättning av maskininlärning, som undertiteln syftar på, handlar om prediktiv AI eller prediktiva analysprojekt. Företagsmaskininlärning. Man skapar en prediktiv modell från data.
Det är vad maskininlärning gör. Den lär sig från data och kapslas in som regler, formler eller något annat i en modell. Och för att vara tydlig: både generativ AI och prediktiv AI bygger på eller använder maskininlärning. Båda är kategorier av användningsområden inom maskininlärning, men slutresultaten är mycket olika system som tjänar mycket olika syften.
När det gäller prediktiv AI görs förutsägelser på organisationsenhetsnivå, till exempel kunden, vårdpatienten, transaktionen som kan vara ett bedrägeri, satelliten som kan få slut på batteri, platsen där man borrat efter olja och som kan vara produktiv eller tåghjulet som kan gå sönder. Det handlar om den detaljnivån.
Användningsområdena är i praktiken oändliga. Men även om den här typen av användningsområden inom maskininlärning, alltså prediktiv analys och företagsmaskininlärning, har funnits i årtionden – sedan sextiotalet, då vi använde regression för riktad marknadsföring och bedrägeridetektering, kreditbedömning och liknande – är det ett potentiellt mycket mognare område.
Det har funnits mycket längre, men precis som generativ AI har det ännu inte vuxit upp. Det har inte professionaliserats på en mycket viktig punkt. Det är därför jag skrev boken och också därför jag grundade och var med och grundade mitt nystartade företag Gooder AI, där vi försöker överbrygga det sista gapet, den sista sträckan mellan teknik och affär.
Teknik och affär är ett välkänt gap mellan exempelvis teknisk personal, datavetare och kvantitativa analytiker, och deras kund på affärssidan – personen som ansvarar för den verksamhet som ska förbättras med en modells förutsägelser. Gapet är så stort att det dödar projekt om och om igen.
Det som särskilt händer är att datavetaren kommer till dig och säger: ”Hej, jag har byggt den maskininlärningsmodell du bad mig bygga för att förutsäga vilken kund som kommer att avsluta, lämna eller säga upp sig.” Det är synonymer och kallas churnmodellering. Nu kan du rikta ett lojalitetserbjudande eller en rabatt till de kunder med hög risk, något du inte har råd att ge till hela kundbasen, men siffrorna blir bra om du bara ger det till högriskkunderna.
Prediktiva användningsområden kan ofta formuleras som att man förutsäger något dåligt för att kunna ingripa: förutsäg vilken interaktion med generativ AI som kommer att gå fel så att du kan sätta in en människa, förutsäg vilken transaktion som kommer att visa sig vara bedräglig så att du kan blockera den, förutsäg vilken kund som kommer att säga upp sig eller vilken medarbetare som kommer att sluta.
Hewlett Packard gjorde detta för alla sina 300 000 medarbetare innan HPE knoppades av. Jag beskrev det i min första bok och de presenterade det på min konferens.
I vilket fall som helst kommer datavetaren och säger: ”Jag har byggt modellen. Den förutsäger väldigt bra. Det är en sund modell. Den har lärt sig från data. Den har klarat alla tekniska kontroller, så det är bara att driftsätta den.” Då säger affärens intressent: ”Hur bra är modellen? Jag vet att vi inte har magiska kristallkulor. Vi kan bara ange sannolikheten för att en individ kommer att klicka, köpa, ljuga eller dö. Det handlar i allmänhet om att spela på oddsen.”
”Så säg mig, hur bra är modellen? Hur väl lyckas vi med den data som finns?” Datavetaren svarar nästan alltid något i stil med: ”Den är fantastisk. Arean under ROC-kurvan är 0,837.” Sedan följer en lång, obekväm tystnad. Datavetare är i allmänhet utbildade och utrustade för att beräkna det vi kallar tekniska prestationsmått: precision, återkallning, F-värde, lyft och area under kurvan.
Även träffsäkerhet är bara ett tekniskt mått. De berättar bara om den råa, abstrakta prediktiva prestationen jämfört med en baslinje, som slumpmässig gissning. De ger en god uppfattning om att modellen tekniskt sett är mycket bättre än att gissa, vilket är bra att veta.
Det är viktigt och i allmänhet det mesta vi kan hoppas på eftersom vi inte har en magisk kristallkula. Men det säger ingenting om det potentiella värdet, exempelvis hur mycket pengar du skulle tjäna genom att använda modellen för riktad marknadsföring, lojalitetserbjudanden, bedrägeridetektering eller prediktivt underhåll.
Vem ska anställas och vem ska man försöka behålla som medarbetare? Det handlar alltid om att rikta begränsade resurser och göra det på ett förutsägbart sätt. Men när man vill beräkna resultatet i form av ekonomiska prestationer, vinst, besparingar eller andra relevanta affärsmått är det fortfarande inte en vanlig övning inom datavetenskapen.
På sätt och vis är jag nästan lika förbryllad som alla andra. Jag har varit inom området och arbetat med maskininlärning i mer än 30 år. Jag gick in i området som en tekniknörd, av samma anledning som de flesta datavetare: det är den häftigaste tekniken och man lär sig från data för att upptäcka mönster och formler som fungerar lika bra på okända, unika och nya fall och situationer.
Det är häftigt. Tekniskt sett, i den mycket väldefinierade betydelsen av ordet, har systemet faktiskt lärt sig något och det fungerar. Man går in i området för att man är nördig, men vi tenderar att dyrka kärntekniken och bli mer entusiastiska över raketvetenskapen än över själva uppskjutningen av raketen.
När man vill skjuta upp raketen efter att ha byggt något måste man testa den utifrån de nyckeltal som betyder något. Man måste stresstesta raketen. Vi kan bygga raketen, men vi måste också kunna styra den och få en uppfattning om dess prestanda.
Det mycket nödvändiga steget att faktiskt beräkna affärsmått och ekonomisk prestation, som vinst och besparingar, innebär att göra en prognos eller uppskattning av hur stor affärsnyttan skulle bli om vi faktiskt använde modellens förutsägelser. Det är därför vi byggde Gooder AI, och det är en central del av min bok The AI Playbook.
Den dåliga nyheten är att området fortfarande misslyckas för det mesta. De flesta prediktiva modeller som utvecklas från data med avsikten att användas i företagsverksamhet når aldrig driftsättning. Den goda nyheten är att det bara handlar om den sista sträckan. Vi har redan färdats 10 000 mil. Vi står på jättars axlar: människorna som utvecklade maskininlärningsalgoritmer som lär sig från data. Nu behövs bara en organisatorisk justering och ett djupt samarbete mellan teknik- och affärssidan så att de talar samma språk, inklusive affärsmått.
På så sätt kan vi reparera den dystra driftsättningsgraden och skapa värde mycket oftare.
David Rice: Att bygga ett globalt team borde inte innebära att man jonglerar med fem olika system för HR, löner och IT. Deel samlar allt på ett ställe så att du kan anställa, introducera, betala och utrusta människor var som helst utan det vanliga kaoset. Oavsett om du anställer medarbetare i tio länder eller hanterar konsulter över flera tidszoner sköter Deel efterlevnad, förmåner och löner på ett ställe. Det innebär färre verktyg, färre problem och mer tid att fokusera på människorna.
Redo att se hur gränslös rekrytering faktiskt ser ut? Besök deel.com/pmp. Det är deel.com/pmp för att boka en demonstration. Deel.com/pmp. Deel – anställ, hantera och betala vem som helst, var som helst.
Av ren nyfikenhet: vilken är den svåraste förändringen företag måste göra om de ska komma bortom affärsmåtten, eller hur de mäter tekniken, och i stället fokusera på den organisatoriska effekten?
Eric Siegel: Det är en bra fråga. Att bredda måtten är en sak som behöver justeras, men det är bara en del av det. Mer generellt definierar man ett prediktivt AI-projekt utifrån ett par saker: vad som ska förutsägas och vad som ska göras åt det. Vad sätter man sannolikheter på?
Vad är det exakt man förutsäger? Vem kommer att köpa om personen kontaktas? Vilka transaktioner visar sig vara bedrägliga? Och vad ska göras åt det? Det är ingripandet eller det som tar vara på möjligheten. Om du förutsäger något positivt, exempelvis vem som kommer att köpa om personen kontaktas, kontaktar du naturligtvis dessa personer.
Detta par – vad som förutsägs och vad som görs åt det – definierar projektet. Det finns många möjliga användningsområden, men det är bokstavligen bara det första av sex steg som jag formaliserar i The AI Playbook som det centrala ramverket Biz ML, en affärsmetod för att driva maskininlärningsprojekt framgångsrikt hela vägen till driftsättning.
Den centrala ingrediensen genom alla dessa steg är ett djupt samarbete mellan teknik och affär. Datavetare kan inte göra detta i ett vakuum. Prediktiva AI-projekt är alltid ett konsultuppdrag. Det är inte en teknisk installation. Det är inte som att installera en bättre databas som fungerar snabbare och bara lägga in den underifrån så att allt annat fortsätter fungera på samma sätt.
Nej, när man förändrar verksamheten med förutsägelser, sannolikheter och odds är det en mycket grundläggande förändring av en storskalig verksamhet. Hela processen är därför i första hand ett affärsarbete som råkar använda maskininlärning. Vi måste formulera om det på det sättet.
För att skapa det djupa samarbetet genom alla steg är den största utmaningen förmodligen att affärssidan behöver komma upp i fart, men bara inom ett område som är lättillgängligt, intressant och relevant. Det är inte som att lära sig byta tändstift och exakt förstå hur motorn fungerar. Man behöver bara lära sig köra bilen. Det är en viss nivå av expertis.
Skillnaden är som mellan att åka i en taxi och att själv köra fordonet. Men om du inte kör fordonet i den här analogin når du inte din destination.
Att komma upp i fart är ett av huvudsyftena med min bok The AI Playbook. Det är inget man lär sig på en timme, men det motsvarar knappt en universitetskurs. Det är mycket mindre än så. Det handlar i princip om en bok. En introduktion som ger en halvteknisk men tillgänglig förståelse av hur prediktiva AI-projekt fungerar, vad som krävs för att driva dem, vad man förutsäger, vad som görs åt det och vilka mått som behövs.
Mått är bara aritmetik. Det är särskild aritmetik, men alla kan förstå den och komma överens om samma utgångspunkt så att projekten kan drivas framgångsrikt hela vägen till driftsättning. Då tas de faktiskt i drift, operationaliseras och integreras i verksamheten. Verksamheten förbättras inte och förändras inte om detta inte sker, och den förändringen är själva driftsättningen.
David Rice: Tidigare när du pratade nämnde du att generativ AI och prediktiv AI möts, korsar varandra och samverkar. Du har talat om att kombinera dem eftersom de var och en hanterar några av den andras begränsningar. Vad är ett bra exempel på att de fungerar tillsammans i praktiken, och vilka hinder möter team när de försöker integrera dem?
Eric Siegel: Tack för att du tar upp ämnet igen. Jag har kallat det hybridisering i en del av mitt skrivande och i några nya huvudanföranden. Hybrid kan betyda andra saker också, men här talar vi specifikt om att kombinera, blanda och förena prediktiv och generativ AI. Ett sätt är det jag redan nämnt: att använda prediktiv AI som ett tillförlitlighetslager ovanpå ett generativt AI-system.
Ett annat är att låta generativ AI hjälpa till i ett prediktivt AI-projekt. Jag började med att säga att generativ AI får all uppmärksamhet eftersom den är sexigare och enklare. Jag har tagit upp det sexiga: den verkar så mänsklig och science fiction-aktig. Att den är enklare säger nästan sig självt.
Den är enklare. Den kallas språkmodell eftersom den har utvecklats för och är avsedd att hantera mänskliga språk som engelska. Det innebär att du kan prata med den på engelska. Det krävs väldigt lite utbildning för att börja använda generativ AI. Och om någon inte har provat den, vad väntar ni på?
Den är fantastisk. Just därför kan den hjälpa till att överbrygga gapet mellan teknik och affär. I vår mjukvarulösning Gooder AI fungerar den exempelvis som en affärskonsol för prediktiva AI-projekt. Ett av de viktigaste diagrammen visar två dimensioner. X-koordinaten handlar om att använda en modell för att avgöra hur många enskilda fall man ska kontakta i marknadsföring, blockera om det gäller en potentiell bedräglig transaktion eller inspektera om det gäller en maskin som kan gå sönder.
Från vänster till höger riktar du in dig enligt den prediktiva modellen. Förutsägelserna och sannolikheterna används för att rangordna och prioritera vilka kunder som är mest värdefulla att kontakta och vilka transaktioner som är mest riskfyllda och bör blockeras.
Sedan måste du bestämma exakt var du drar gränsen. Du vill inte blockera för få transaktioner, men inte heller för många. Samma sak gäller marknadsföring och inspektion av utrustning som kan gå sönder. Det finns alltid en slags lagom-zon. Men den ordning där du går igenom spektrumet för att avgöra hur modellen ska användas och hur den ska tas i drift bygger på modellen.
Det är den horisontella X-koordinaten. På Y-koordinaten finns pengarna. Vilken potentiell avkastning, vilka besparingar eller intäkter kommer du att få från det här projektet? Diagrammet stiger ofta först och sjunker sedan, eftersom det finns en optimal zon där resultatet förbättras mest.
Den bilden är en av huvudvyerna i vår programvarulösning Gooder AI, men den är inte en vanlig visuell framställning. Den är mycket grundläggande: bara två dimensioner, och båda är relevanta för verksamheten. Det är ingen raketforskning och man skulle kunna lära ut det i gymnasiet, men det är ändå relativt nytt även för många kvantitativa analytiker.
Som jag nämnt beräknar människor i allmänhet inte ens affärsmått som ekonomiska besparingar och vinst. Det har ännu inte blivit en del av kulturen, trots att det är absolut nödvändigt. Eftersom det är nytt vore det trevligt att kunna ställa en miljon frågor utan att vara rädd för att tråka ut en datavetare eller låta dum.
Vi har integrerat en språkmodell och gett chattboten mycket specialiserade instruktioner kopplade till det du ser. Nu kan du ställa en fråga: ”Varför går kurvan upp och ner? Förklara det som en berättelse för ett barn.” Då säger den: ”Okej, du säljer lemonad. Du har ett lemonadstånd och försöker bestämma hur många förbipasserande kunder du ska rikta dig till.”
Och den gör det väldigt bra. Det är ett annat exempel på hur de två områdena kan förstärka varandra genom att använda generativ AI för att hjälpa människor förstå prediktiva AI-projekt.
David Rice: Jag har sett ett växande argument om att prediktiva modeller kan fungera som kritiska skyddsräcken, särskilt när generativa system hallucinerar eller börjar bete sig oförutsägbart.
Hur tror du att prediktiv AI kan struktureras som ett säkerhetslager i operativa arbetsflöden?
Eric Siegel: Det är några av de klassiska användningsområdena som jag tog med redan i den första upplagan av min första bok. Predictive Analytics kom ut 2013 och uppdaterade upplagor kom 2016. Shell Oil använder exempelvis prediktion för att avgöra vilka team som löper störst risk att råka ut för incidenter på sina oljeplattformar. Det handlar om arbetsplatssäkerhet på team-, miljö- eller fallnivå.
Det passar bra, precis som allt annat. Det som skiljer prediktiva användningsområden från prognostisering är att båda försöker uppskatta framtiden, men prognostisering brukar handla om ett enda resultat: kommer ekonomin att gå upp eller ner? Hur många glassar kommer vi att sälja nästa kvartal?
Med prediktiv AI och prediktiv analys använder man däremot maskininlärning för att göra en förutsägelse för varje enskilt fall. Vilken individ kommer troligast att hålla i en glass? Vilken väljare kommer att rösta på din kandidat, eller är mest benägen att övertalas att rösta på din kandidat om en volontär knackar på dörren?
Eftersom det sker på fallnivå och tillämpas på storskalig verksamhet blir det uppenbart mycket mer värdefullt. Det tillämpas på miljontals fall. Det är vad storskalig verksamhet består av: miljontals mikrob beslut. Den heliga graalen för att driva eller förbättra varje sådant mikrobeslut är att förutsäga ett relevant resultat eller beteende som hör ihop med beslutet.
Den goda nyheten är att eftersom man tillämpar det så många gånger får man de stora talens lag, vilket kompenserar för att vi tyvärr inte har en magisk kristallkula utan bara sannolikheter. Sannolikhet låter som ett mystiskt ämne och många undviker det. Det är sant att matematiken för att beräkna en sannolikhet kan vara komplex, men resultatet från dessa system och varje enskild sannolikhet är inte tekniskt alls.
Det är faktiskt det mest uppenbara näst bästa man kan hoppas på utanför en magisk kristallkula. Om vi hade en hypotetisk magisk kristallkula skulle den alltid ge det definitiva svaret: ”Den här personen kommer att köpa” eller ”Den här transaktionen kommer definitivt att visa sig vara bedräglig.”
Utan det, vad är då det näst bästa? Ett tal mellan noll och hundra. Vilka är chanserna för just det här fallet? Det gör det möjligt att sortera och prioritera många fall och besluta vilka som ska behandlas på ett sätt och vilka på ett annat.
Den grundläggande idén att ange odds och sedan prioritera kan tillämpas på säkerhet och på många andra områden. Det är ingen raketforskning att avgöra exakt hur det ska användas. Det är centralt för vad affärens intressenter behöver förstå om de vill dra nytta av tekniken.
Nästa steg är att de måste delta i projektet. De kan inte bara skicka iväg datavetarna. Det är akilleshälen och problemet. Det hänger ihop med att vi dyrkar och glorifierar tekniken, eftersom den grundläggande förmågan att lära sig från data och göra förutsägelser verkligen är häftig.
Men man kan inte säga att tekniken automatiskt är värdefull bara för att man använder den bästa tekniken. Den är värdefull först när man använder resultatet av datavetarens hårda arbete med rätt beräkningar. Datavetarna skapar en prediktiv modell som kan generera förutsägelser. Därefter måste du agera utifrån förutsägelserna.
Du måste integrera dem i den storskaliga verksamheten. Det är där pengarna finns. Det är där saker faktiskt börjar ge resultat, verksamheten förbättras och värde skapas. Det enda sättet att nå dit är genom ett djupt samarbete.
Att dyrka tekniken leder till den falska berättelsen att vi ska använda den bästa tekniken, maskininlärning, och att en certifierad expert på datavetenskap ska förbereda data och skapa en modell. Då skulle det vara värdet. Men nej, det är inte värdet. Värdet är det övergripande affärsprojektet, som inkluderar modellen och ett djupt samarbete fram till den punkt där den faktiskt har integrerats.
Samarbetet omfattar personer på affärssidan som har lärt sig vad som ska förutsägas och vad som ska göras åt det genom de sex stegen. Inget av dem är raketforskning. De innehåller raketforskning, men den delen kan överlåtas till datavetaren. De innehåller också många tillgängliga och relevanta delar: att ange sannolikheter, rangordna, sortera, dra en gräns och besluta hur enskilda fall ska behandlas.
David Rice: Många ramverk för prediktiv AI brukar betona datamodellering. Men i din metod lyfter du fram andra saker, som definition av förutsägelsen, operativ integrering och löpande iteration. Vilka är några av de mindre uppenbara men kritiska stegen som företag ofta hoppar över när de börjar investera i prediktiv AI, och hur påverkar det resultaten?
Eric Siegel: Jag gillar hur du formulerar frågan. Vilka huvudsteg hoppar de över? Svaret är att de i princip hoppar över alla steg eller de flesta stegen från affärssidan. Datavetarna försöker göra alla steg, men de är bara utbildade för att utföra de tekniska beräkningarna och göra en teknisk utvärdering.
Jag försöker också få dem att hjälpa till att överbrygga gapet. Konferensen jag driver heter Machine Learning Week och har funnits sedan 2009. Den hette tidigare Predictive Analytics World. Mer än hälften av deltagarna är datavetare. Jag försöker få dem att nå över till andra sidan, inte bara beräkna tekniska mått utan också affärsmått och få kunden eller intressenten att delta i detalj.
På affärssidan handlar kärnstegen om vad som ska förutsägas och vad som ska göras åt det. En annan del är hur väl det förutsägs. Det blir en trio: vad som förutsägs, hur väl det förutsägs och vad som görs åt det. Det är inte raketforskning, bara grunderna som definierar projektet och dess krav.
De sex stegen i Biz ML-ramverket i boken The AI Playbook består av två uppsättningar om tre som handlar om exakt dessa tre saker: vad som förutsägs, hur väl och vad som görs åt det, inte riktigt i den ordningen. De avslutande tre stegen är samma tre steg som datavetare har arbetat med sedan sextiotalet.
Först förbereder man data enligt vad man behöver och vad man försöker förutsäga. Sedan gör man den faktiska maskininlärningsdelen och tränar modellen. Det är raketforskningsdelen: att lära sig från data för att skapa modellen. Därefter kommer driftsättningen, alltså den faktiska integreringen.
Dessa tre steg har alltid funnits där per definition. De andra tre är produktionsförberedande och motsvarar steg fyra, fem och sex. Det är lite som Star Wars, där A New Hope var episod fyra. Den ursprungliga trion av steg som alltid varit en del av prediktiva projekt och maskininlärningsprojekt är alltså: förbered data, träna modellen och driftsätt modellen.
Det börjar med steg fyra eftersom de tre föregående är produktionsförberedande. Alla sex steg kräver dock ett djupt samarbete med affärssidan. De tre första handlar om att definiera vad som ska förutsägas, hur väl och vad som ska göras åt det, även om det inte riktigt är i den ordningen.
Det finns också en artikel i Harvard Business Review som ger en översikt. Man behöver inte ha boken, men om man vill delta från affärssidan i ett sådant projekt är det syftet med boken. Du går inte bara igenom de sex stegen i bokens sex huvudkapitel, utan bygger samtidigt upp en halvteknisk och tillgänglig förståelse så att du sedan är förberedd på att delta.
David Rice: Okej, tyvärr är det allt vi hinner med i dag, Eric, men jag vill tacka dig för att du kom till programmet. Det här har varit oerhört fascinerande.
Eric Siegel: Utmärkt, David. Tack så mycket för att jag fick vara med.
David Rice: Lyssnare, om ni inte redan har gjort det, gå till peoplemanagingpeople.com/subscribe och registrera er för nyhetsbrevet. Ni får poddavsnitt som detta och alla de senaste artiklarna vi publicerar direkt i inkorgen. Om ni vill lära er mer om ämnet bör ni definitivt läsa The AI Playbook. Den är verkligen värd er tid.
Och tills nästa gång: fortsätt vara nyfikna på prediktiv AI. Gå inte bara vilse i den generativa dimman.

