

Czego Twoi agenci nie ukończą bez Ciebie

Kluczowa zmiana: Upwork sprzedaje teraz realizację pracy, w ramach której systemy łączą ludzi i maszyny, aby osiągać rezultaty, zamiast obsadzać stanowiska.
Ograniczenia testu porównawczego: Test automatyzacji Upwork obejmował wybrane zadania o niskim poziomie złożoności, dlatego jego wyniki nie mogą reprezentować większości pracy wykonywanej na platformie.
Wartość człowieka: Informacje zwrotne od ludzi poprawiały realizację zadań przez agentów, ale wymagały znacznie więcej czasu i nigdy nie zapewniały niezawodnego powodzenia we wszystkich zadaniach.
Luka w weryfikacji: Automatyzacja działa najlepiej, gdy wyniki można obiektywnie sprawdzić; praca wymagająca oceny i współpracy międzyfunkcyjnej nadal potrzebuje odpowiedzialnego człowieka.
Test biznesowy: Mierz automatyzację na podstawie zaakceptowanych wyników, traktuj ekspercką weryfikację jako etap produkcji i chroń stanowiska średniego szczebla, które rozwijają przyszłe umiejętności oceny.
Upwork przestał nazywać siebie platformą talentów. Teraz używa określenia „platforma realizacji pracy”, a ta zmiana to coś więcej niż tylko nowe pozycjonowanie.
Na platformie handlowej klient zatrudnia osobę. Na platformie realizacji pracy klient określa oczekiwany rezultat, a system decyduje, jaka kombinacja ludzi i maszyn go osiągnie.
Andrew Rabinovich, który kieruje działem AI w Upwork, opisuje kupowaną jednostkę jako coś mniejszego niż praca i mniejszego niż rola. Jak powiedział podczas AI4, dwie dekady danych platformy sugerują, że ogromną różnorodność prac publikowanych na Upwork można rozłożyć na około 500–1000 powtarzalnych zadań. Nazywa je „atomowymi jednostkami pracy” — funkcjami bazowymi, które można łączyć na nowo, aby utworzyć dowolne zlecenie, jakie klient może opublikować.

Firma, która zamierza sprzedawać rozłożoną na części pracę, przyjmuje na siebie pewne zobowiązanie. Musi wiedzieć, które z tych elementów maszyna może ukończyć samodzielnie, i musi wiedzieć to z wystarczającą precyzją, aby oprzeć na tej odpowiedzi decyzje finansowe.
Dlatego Upwork przepuścił rzeczywiste zlecenia klientów przez test porównawczy, opublikował wyniki jako Indeks produktywności człowieka i agenta oraz opisał metodologię w artykule opublikowanym za pośrednictwem arXiv w grudniu.
Najważniejszym ustaleniem jest to, co agenci ukończyli. Bardziej użyteczne jest jednak ustalenie, ile kosztuje doprowadzenie ich do ukończenia zadania i kto ostatecznie ponosi ten koszt.
Praca najbardziej podatna na automatyzację
Metodologia zasługuje na większą uwagę niż wyniki, ponieważ wyznacza granice tego, co wyniki mogą oznaczać.
Upwork wybrał 322 rzeczywiste zlecenia, które zostały już opublikowane przez płacących klientów i ukończone przez niezależnych wykonawców aż do momentu zaakceptowania ich przez klientów. Eksperci wykonujący te zlecenia opracowali dla każdego z nich kryteria oceny — od 5 do 20 — podzielone na krytyczne, ważne, opcjonalne i dotyczące potencjalnych problemów. Zlecenie uznawano za ukończone tylko wtedy, gdy spełnione zostały wszystkie kryteria krytyczne i ważne.
Pracę wykonały trzy modele: Claude, Gemini i GPT-5.
To właśnie kryteria wyboru wymagają od osoby zarządzającej chwili namysłu. Zlecenia ograniczono do umów o stałej cenie, z jednym etapem realizacji i jasno określonym zakresem. Ich czas trwania wynosił od dziewięciu godzin do ponad 100 dni, więc nie były to jednolicie mikrozadania. Wykluczono pracę otwartą i złożoną, uzasadniając to tym, że agenci nie mieliby rozsądnych szans na jej wykonanie.
Upwork opisuje tę wykluczoną kategorię jako zdecydowaną większość pracy realizowanej na platformie.
Jeszcze jedno ograniczenie ma znaczenie dla każdego, kto zamierza odrzucić te wyniki. Agenci byli celowo utrzymywani w bardzo podstawowej konfiguracji. Każdy z nich odczytywał treść zlecenia i wszelkie załączniki, tworzył plan, przygotowywał rezultat i kończył działanie. Bez wyszukiwania w internecie, dostępu do zewnętrznych danych, dodatkowych narzędzi i szkolenia na danym typie zadań.
W rezultacie autorzy zauważają, że ustalenia nie są reprezentatywne dla systemów wyposażonych w liczne narzędzia, a własne liczby określają jako ostrożne szacunki.
Każda z poniższych wartości została więc zmierzona na najłatwiejszej dostępnej pracy, po wcześniejszym usunięciu trudnych przypadków, z wykorzystaniem agentów pozbawionych narzędzi, które faktycznie wdraża większość firm.
Wsparcie administracyjne jest trudniejsze, niż się wydaje
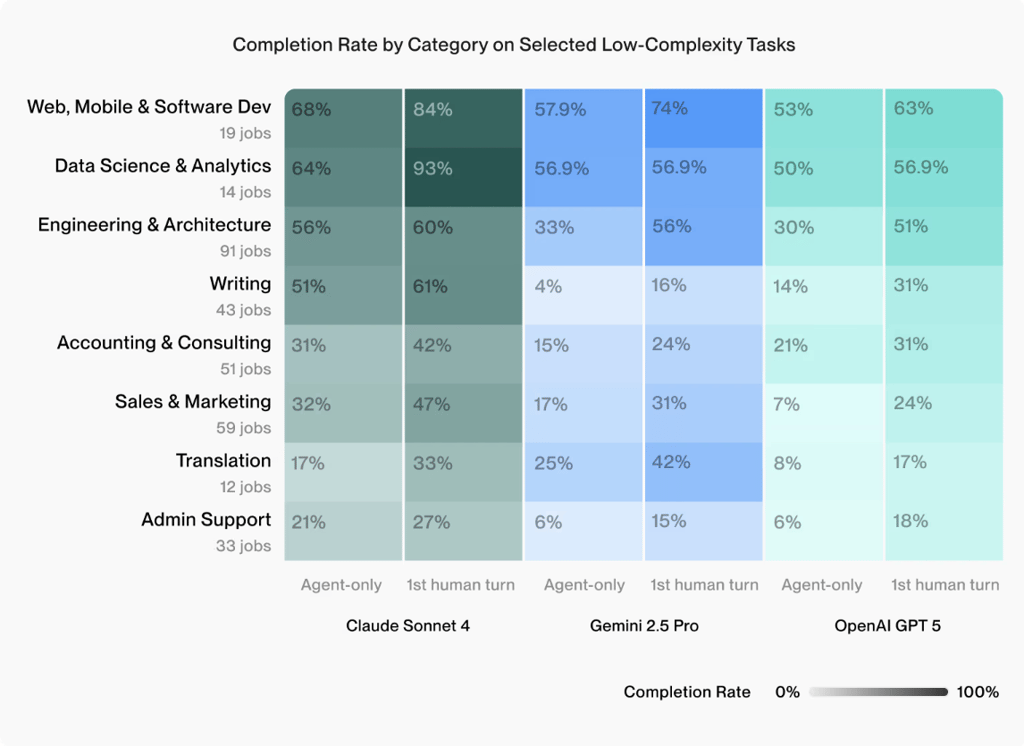
Działając samodzielnie, agenci spełnili wszystkie kryteria w przypadku od 4 do 68% zleceń, zależnie od kategorii i modelu. Tworzenie stron internetowych i oprogramowania znalazło się na szczycie. Tuż za nim uplasowała się analiza danych.
Wsparcie administracyjne zajęło średnio ostatnie miejsce wśród trzech modeli, uzyskując wynik 6% w przypadku dwóch z nich.
Taka kolejność jest całkowicie sprzeczna ze sposobem, w jaki układa się większość planów automatyzacji. Praca administracyjna jest wybierana jako pierwszy cel, przy rozsądnie brzmiącym założeniu, że to najprostsza rzecz w całej organizacji.
Test porównawczy sugeruje, że łatwość opisania i łatwość zweryfikowania to odrębne cechy, a tylko ta druga pozwala przewidzieć, czy agent będzie w stanie ukończyć zadanie.
Sposób, w jaki sam Rabinovich ujmuje tę kwestię, pokazuje, jak łatwo przyjąć takie założenie. Zapytany o wpływ na niezależnych wykonawców, opisał niskopoziomową pracę — tworzenie logo i pisanie podsumowań różnych rzeczy — jako już całkowicie zautomatyzowaną. Test porównawczy jego firmy ocenił pisanie na poziomie od 4% do 51%, zależnie od modelu, przy czym Gemini znalazł się na najniższym poziomie tego zakresu. Intuicja i pomiar wskazują na różne kierunki.
Dodanie rundy informacji zwrotnej od eksperta zwiększyło ogólny poziom ukończenia zadań w przypadku każdego modelu. Claude przeszedł z 39,8% do 51,2% w przypadku zadań o niskiej złożoności po zaledwie jednej interwencji człowieka. Gemini przeszedł z 19,9% do 32,3%. GPT-5 przeszedł z 19,6% do 33,5%. W wartościach bezwzględnych oznacza to poprawę o 11–14 punktów procentowych po jednym zaangażowaniu człowieka.

Upwork przedstawia górną granicę względnego zakresu jako wzrost sięgający 70%, co jest poprawnym rachunkiem opartym na niskiej wartości bazowej GPT-5 i warto czytać to w zestawieniu z wartościami bezwzględnymi.
Zmiany na poziomie kategorii były nierównomierne. Wynik Claude'a w zakresie wykonywania zadań z dziedziny analizy danych wzrósł z 64% do 93%. Wynik Gemini w zakresie pisania wzrósł z 4% do 16%. Wynik Gemini w zakresie analizy danych nie zmienił się wcale.
Nic nie osiągnęło 100%. Nawet w przypadku najłatwiejszej dostępnej pracy, gdy system był prowadzony przez eksperta.
Weryfikacja to element, którego nie udało nam się rozwiązać
Rabinovich ocenia, że jakościowy udział pracy na platformie przekracza 90%, i bezpośrednio mówi o tym, co oznacza to dla oceny. Praca deterministyczna ma wbudowany mechanizm weryfikacji. Tłumaczenie może zostać zweryfikowane przez inny model. Kod albo się kompiluje i przechodzi testy, albo nie. W przypadku całej reszty jedyną dostępną metodą weryfikacji jest osoba dysponująca odpowiednim osądem, która analizuje wynik i decyduje, czy jest on wystarczająco dobry.
Opisał to jako problem w dużej mierze nierozwiązany i poszedł jeszcze dalej.
Rozwiąż problem niezawodnej walidacji jakościowego wyniku, a mniej więcej rozwiążesz problem AI.
Autorzy artykułu ostrożnie podchodzą do tego, co dowodzą w tej kwestii ich własne liczby. Nie przeprowadzili porównywalnych drugich prób przeprowadzonych wyłącznie przez agenta dla zadań, które zakończyły się niepowodzeniem, co oznacza, że poprawy nie można oddzielić od efektu samego umożliwienia modelowi ponownej próby. To ich ujawnione zastrzeżenie, wymienione w sekcji dotyczącej ograniczeń badania.
Badanie potwierdza coś węższego, niż sugeruje narracja Upworka. Druga próba po otrzymaniu informacji zwrotnej od eksperta daje lepsze wyniki niż pierwsza. Nie zmierzono, jaka część tej poprawy wynika z informacji zwrotnej, a jaka z ponownej próby.
Trwałym wnioskiem jest górna granica możliwości. W warunkach dobranych pod kątem sukcesu agenta mniej więcej co piąte zadanie, które początkowo zakończyło się niepowodzeniem, zostało uratowane dzięki drugiej próbie prowadzonej przez człowieka, a odsetek ukończenia osiągnął maksymalnie 51% w przypadku najsilniejszego modelu. Próby prowadzone przez człowieka trwały również około czterech razy dłużej — 14,5 minuty w porównaniu z 3,6 minuty.
Własna decyzja produktowa Upworka wskazuje w tym samym kierunku. UMA, flagowy system AI firmy, został zbudowany jako agent orkiestrujący, a nie wykonawca. Interpretuje intencje, rozkłada je na części, kieruje poszczególne elementy do ludzi lub maszyn i sprawdza wynik. Nie wykonuje zadania.
Firma, która ma wszelkie komercyjne powody, by sprzedawać autonomiczne wykonywanie zadań, zaprojektowała swój centralny system wokół założenia, że człowiek pozostaje zaangażowany w pracę.
Dwa pytania, zanim sfinansujesz przepływ pracy
Są dwa kluczowe pytania, które warto zadać na temat tego, co mają robić agenci.
Czy wynik można sprawdzić na podstawie czegoś obiektywnego? Zestawu testów, uzgodnienia, reguły zgodności albo liczby, która albo się zgadza, albo nie.
Czy praca pozostaje w obrębie jednej funkcji i jednego formatu? Czy może przechodzi od zaplecza technicznego, przez interfejs użytkownika i teksty, aż po akceptację marki, zanim ktokolwiek będzie mógł uznać ją za zakończoną?
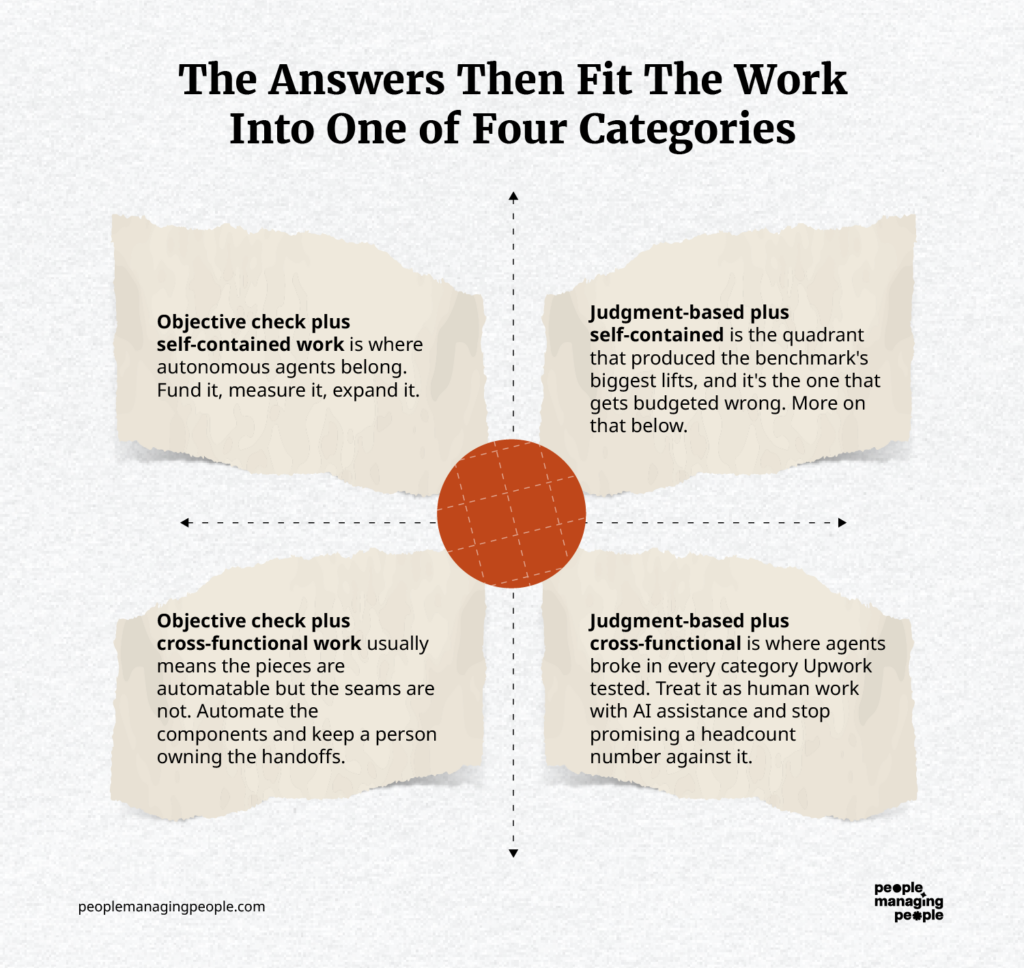
Obiektywna kontrola i praca samodzielna — to obszar, w którym powinny działać autonomiczne agenty. Finansuj ją, mierz i rozwijaj.
Obiektywna kontrola i praca międzyfunkcyjna zwykle oznaczają, że poszczególne elementy można zautomatyzować, ale punkty styku już nie. Automatyzuj komponenty i pozostaw człowieka odpowiedzialnego za przekazywanie pracy.
Osąd i praca samodzielna to ćwiartka, w której odnotowano największe wzrosty w badaniu, a zarazem ta, dla której budżet jest ustalany w niewłaściwy sposób. Więcej na ten temat poniżej.
Osąd i praca międzyfunkcyjna to obszar, w którym agenty zawiodły w każdej kategorii testowanej przez Upwork. Traktuj ją jako pracę człowieka wspomaganą przez AI i przestań obiecywać w jej przypadku konkretną liczbę etatów.
Własne modelowanie ekonomiczne Upworka prowadzi mniej więcej do tego samego wniosku. Praca wyłącznie agenta wygrywa w przypadku zadań o niskiej wartości, w których koszt błędu jest niewielki, współpraca wygrywa w środku skali, a pełna realizacja przez człowieka wygrywa w przypadku pracy o wysokiej wartości, gdzie koszt złego wyniku przewyższa oszczędności z automatyzacji.
Zadanie, które Upwork wybrał do pokazania
Strona HAPI zawiera pięć przykładowych zadań z materiałami do pobrania. Jedno z nich dotyczy pozyskiwania potencjalnych klientów. Należy przefiltrować arkusz aplikacji mobilnych, pozostawiając te, których siedziby znajdują się w USA, znaleźć od dwóch do czterech kontaktów marketingowych w każdej z nich i wypełnić dziewięć nazwanych kolumn.
Obiektywnie weryfikowalne. Jedna funkcja, jeden format. Kryteria oceny są widoczne na stronie i żadne z nich nie wymaga subiektywnego gustu.
Oba rezultaty uznano za niespełniające kryteriów oceny. Agent pracujący samodzielnie poniósł porażkę. Porażkę poniósł również agent współpracujący z ekspertem, który go prowadził.
Upwork umieścił tę informację na własnej stronie marketingowej, obok twierdzenia, że współpraca może zwiększyć odsetek ukończonych zadań nawet o 70%. Należy docenić firmę za ujawnienie tych danych, a następnie wyciągnąć z tego wnioski, ponieważ to zadanie bardzo przypomina pracę, którą firmy już dziś powierzają agentom.
Właściwa osoba w pętli?
Każda prezentacja dostawcy przedstawia człowieka w pętli jako funkcję bezpieczeństwa. Lektura kryteriów oceny ujawnia jednak inne pytanie.
Wszyscy recenzenci Upwork mieli 100% wskaźnik sukcesu zleceń oraz status Top Rated lub Top Rated Plus. Łącznie zarobili na platformie ponad 1 milion dolarów, przepracowując ponad 96 000 godzin.
To najwyższy poziom globalnego rynku talentów. Jest to również jedyna populacja recenzentów poddana badaniu. W opracowaniu zauważono, że zespół nie określił poziomu wiedzy specjalistycznej oceniających ani nie zbadał, jak doświadczenie recenzenta wpływa na wartość jego informacji zwrotnej. Nie uwzględniono wariantu z osobą mniej doświadczoną.
Zatem każda liczba w tym badaniu opisuje najlepszy możliwy przypadek ludzkiego nadzoru, a wpływ obsadzenia tej roli przez kogokolwiek, kto akurat miał wolne moce przerobowe, nie został przez nikogo zmierzony.
To mój argument, a nie wniosek z badania porównawczego, i pociąga on za sobą dwie konsekwencje, których większość planów dotyczących siły roboczej nie uwzględniła w kalkulacjach.
Pierwsza jest taka, że weryfikacja stanowi zdolność produkcyjną, a nie koszty ogólne. W obszarze wymagającym osądu ekspert nie jest punktem kontrolnym dołączonym do zautomatyzowanego procesu. Ekspert jest wkładem, który przekształca szkic w coś gotowego do wysłania, a czterokrotna różnica czasu między tymi dwoma wariantami pokazuje koszt tego wkładu.
Jeśli zaklasyfikujesz to jako nadzór, zaniżysz skalę procesu, a jednocześnie zawyżysz oszczędności. Kalkulacja, która uzasadniła inwestycję, przestaje opisywać proces, który rzeczywiście zbudowałeś.
Druga konsekwencja jest bardziej odległa i poważniejsza. Każdy plan ograniczający liczbę stanowisk średniego szczebla w celu sfinansowania wydatków na sztuczną inteligencję jednocześnie zmniejsza grupę osób, które za trzy lata zdobędą wystarczające doświadczenie, by zakwestionować decyzję modelu.
Ekspercka ocena nie jest poświadczeniem kwalifikacji, lecz osadem doświadczenia. Narasta poprzez wykonywanie pracy, początkowo niedoskonałe, gdy ktoś bardziej doświadczony koryguje twoje błędy. Automatyzując najniższe szczeble, zachowujesz dzisiejszych recenzentów, ale usuwasz mechanizm, który tworzy jutrzejszych.
To najpierw problem przywództwa, a dopiero potem problem kadrowy, i należy do osoby, która podpisuje uzasadnienie biznesowe automatyzacji.
More Articles
- Jak zmienić dostawcę EOR bez zakłóceń: proces w 7 krokach
- Wybór systemu zarządzania nauką: prosty 5-etapowy proces
- Jak uzasadnić biznesowo zakup oprogramowania HR: przewodnik w 10 krokach
- Koszty oprogramowania do zapewnienia zgodności HR: przewodnik po cenach na 2026 rok
- Wdrożenie Oracle Cloud HCM: kompletny przewodnik krok po kroku
Jeśli agenci staną się kupującymi, produktem będzie ocena
Rabinovich uważa, że kolejnym etapem rozwoju tego rynku będzie przekształcenie agentów w źródło popytu, a nie tylko źródło podaży. Model realizujący zadanie, którego nie potrafi zweryfikować — pytanie medyczne, rekomendację restauracji lub cokolwiek opartego na guście — zatrudnia w czasie rzeczywistym człowieka, by ten to sprawdził. Człowiek nie realizuje projektu, lecz po prostu zatwierdza rezultat.
To osoba zarządzająca platformą opisuje korzyści dla własnej firmy, dlatego należy odpowiednio uwzględnić ten punkt widzenia.
Konsekwencje dla siły roboczej pozostają aktualne niezależnie od tego, czy mechanizm przyjmie właśnie taką formę. Jeśli weryfikacja jest trwałym wkładem człowieka, to role zachowujące wartość definiuje osąd dotyczący jakości rezultatu, a nie wielkość produkcji.
Obecnie role te są rozproszone między różnymi poziomami seniority, rodzinami stanowisk i centrami kosztów, które często nie są mapowane, co oznacza, że większość organizacji nie potrafi powiedzieć, kto je pełni ani ile kosztowałoby ich zastąpienie.
Cztery działania
Co zatem możesz zrobić, aby ocenić, czy jesteś gotowy zacząć przekazywać agentom przynajmniej część pracy do wykonania?
- Wybierz dziesięć rezultatów z najbardziej zautomatyzowanego procesu i pokaż je osobie, która wcześniej odpowiadała za tę pracę. Zapytaj, ile z nich wysłałaby klientowi bez zmian. Ta liczba jest rzeczywistym wskaźnikiem automatyzacji.
- Dla każdego zautomatyzowanego procesu wskaż osobę uprawnioną do odrzucenia rezultatu. Następnie sprawdź, czy może skorzystać z tego uprawnienia bez eskalowania sprawy.
- Przeklasyfikuj czas poświęcany na weryfikację w procesach należących do obszaru wymagającego osądu. Przenieś go z kategorii nadzoru do kategorii produkcji i ponownie przeprowadź analizę uzasadnienia biznesowego.
- Przeczytaj w umowach z dostawcami, co oznacza ukończenie zadania. Akceptacja oceniana według kryteriów dla każdego elementu oraz „podjęto próbę wykonania zadania” to różne twierdzenia, a tylko jedno z nich odpowiada temu, co zmierzono w badaniu porównawczym.

