

Gdy liderzy HR stają się twórcami

Wnioski z eksperymentu: Wspólne projekty AI dostarczyły głębokich spostrzeżeń na temat możliwości HR wykraczających poza samo tworzenie narzędzi.
Koncentracja na problemie: Przejście od analizy nastrojów do mapowania umiejętności uwypukliło znaczenie definiowania jasnych i osiągalnych celów.
Sceptycyzm wobec AI: Specjaliści HR mierzą się z poważnymi wyzwaniami w zakresie odpowiedzialności i przejrzystości istniejących platform AI.
Struktura narzędzia: Narzędzie AI do oceny podkreślało współpracę, umożliwiając użytkownikom potwierdzanie lub kwestionowanie informacji zwrotnych generowanych przez AI.
Testowanie kontradyktoryjne: Skuteczne tworzenie narzędzi wymaga rygorystycznych testów z użyciem zróżnicowanych danych wejściowych, aby skutecznie uwzględniać przypadki brzegowe.
Spotkania były zaplanowane na godzinę. Niemal zawsze się przedłużały.
To nic niezwykłego, gdy grupa specjalistów HR spotyka się, aby porozmawiać o AI. Niezwykłe było natomiast to, co mieli zrobić z tą rozmową. Nie przeanalizować jej, nie opublikować na jej temat artykułu opiniotwórczego, lecz faktycznie coś zbudować.
Jesienią 2025 roku zorganizowałem grupy, które nazywałem kohortami twórców: niewielkie grupy specjalistów HR i operacji personalnych, których wytypowałem jako osoby już wykonujące tę pracę i już zastanawiające się na obrzeżach nad tym, co profesja HR może zrobić z AI.

Hipoteza była prosta. Osoby znajdujące się najbliżej problemów są najlepiej przygotowane do tworzenia rozwiązań. Pytanie brzmiało, czy będą w stanie to zrobić.
W sumie stworzyłem cztery kohorty i po drodze zdałem sobie sprawę, że określenie celów tych sesji jest łatwiejsze w teorii niż w praktyce. Ostatecznie większość kohort wygasła, zmagając się z realizacją początkowej wizji lub wyborem jednego celu. Kalendarze, obciążenie pracą i wymagania związane z naszymi rzeczywistymi stanowiskami często prowadziły do rozmów, które przynosiły świetne pomysły, ale nigdy nie doprowadzały do ich realizacji.
Jednak jedna kohorta zebrała się i rzeczywiście dotarła do końca, najlepiej jak potrafiła. Faktem jest, że im głębiej zagłębiasz się w króliczą norę samodzielnego tworzenia, tym trudniej jest uszanować wspólną wizję i sprostać wyzwaniu inżynieryjnemu.
Ta historia jest relacją z tego, co wynikło z tych sesji, i przedstawiam ją jako studium przypadku dotyczące budowania własnych rozwiązań.
Kohorta


Nie byli to sceptycy AI, których trzeba było przekonywać. Byli to praktycy, którzy już postawili na tę chwilę. Kohorta zapewniła im uporządkowaną przestrzeń, aby przestali doradzać i zaczęli tworzyć.
Pierwsza szczera rozmowa
Pierwsza sesja ujawniła coś, co rzadko trafia do publikowanych komentarzy dotyczących HR: jak bardzo ci specjaliści są w rzeczywistości sfrustrowani narzędziami, z których powinni korzystać.
Turnmeyer nadała rozmowie ton. Próbowała uzyskać dokumentację techniczną dotyczącą sposobu działania analizy nastrojów w BambooHR, Paycom i Gusto — nie po to, aby odrzucić te narzędzia, lecz dlatego, że jej zespół prawny musiał je zrozumieć przed zatwierdzeniem ich użycia.
Nie potrafiły odpowiedzieć na jej pytania ani zespoły sprzedażowe, ani przedstawiciele działów prawnych. Funkcje AI istniały. Nie istniała natomiast odpowiedzialność za sposób ich działania.
Gillies mierzyła się z podobnym napięciem. Pojawiły się wewnętrzne głosy wyrażające obawy dotyczące wpływu AI na środowisko, a niektórzy współpracownicy chcieli po prostu zakazać pracownikom korzystania z AI. Gillies się temu sprzeciwiła.
Całkowity zakaz używania AI prowadzi do korzystania z niej w ukryciu i zwiększa ryzyko. Lepszym podejściem jest wdrażanie AI z odpowiednimi zabezpieczeniami.
Melina Gillies · Dyrektorka ds. pracowników, Flex Networks
W wyniku tej pierwszej godziny wyłoniła się diagnoza, z którą grupa mogła się zgodzić. Wbudowane funkcje AI platform HR dla przedsiębiorstw były, jak ujęła to Gillies, „często podstawowe i pozbawione funkcjonalności.”
Narzędzia, które faktycznie działają, zwykle są tworzone na zamówienie — z myślą o konkretnych problemach, konkretnych kontekstach i konkretnych firmach. Turnmeyer chciała mniej narzędzi, a nie więcej — to zdanie często słyszę od liderów ds. ludzi i operacji. Potrafiła wyobrazić sobie przyszłość, w której sprawna AI, zasilona odpowiednimi dokumentami, sprawiłaby, że HRIS stałby się zbędny.
Grupa zmierzyła się również z czymś, co rzadko jest omawiane w tak bezpośredni sposób: etyką śledzenia zachowań. Już na początku pojawił się pomysł wykorzystywania wskaźników odrzucania spotkań, przerw w logowaniu do systemu lub nietypowych godzin pracy jako wskaźników braku zaangażowania.
Omówiono również ograniczenia takiego podejścia. Satterfield wskazała ryzyko, z którym ostatecznie mierzy się każde narzędzie do pomiaru zaangażowania — zmęczenie brakiem działania. Jeśli gromadzisz dane i nie podejmujesz na ich podstawie widocznych działań, pracownicy przestają ufać systemowi. Dane stają się szumem, a narzędzie zmienia się w teatr AI.
Nie byli gotowi zbudować narzędzia do analizy nastrojów. Było zbyt szerokie, obciążone zbyt wieloma dylematami etycznymi i zbyt łatwo można było popełnić w nim katastrofalny błąd. Dlatego zmienili kierunek.
Znalezienie właściwego problemu
Druga sesja rozpoczęła się od szczerego przyznania, że pierwotny kierunek był zbyt ambitny i zbyt niejednoznaczny.
„Nie wiem, czy to mierzy zaangażowanie” — powiedziała Turnmeyer — „czy po prostu mierzy coś, co wymaga rozmowy.”
To rozróżnienie ma większe znaczenie, niż mogłoby się wydawać. Wiele technologii HR popełnia błąd, traktując dane jako substytut rozmowy. Grupa próbowała wykorzystać AI do wskazywania momentów, w których trzeba odbyć rozmowę, a następnie sprawić, by ta rozmowa była lepsza.
Satterfield przedstawiła pomysł, który miał wyznaczyć kierunek dalszej części projektu. Podczas zamrożenia rekrutacji u poprzedniego pracodawcy stworzyła samoocenę umiejętności dla zespołu ds. pozyskiwania talentów — sposób na zestawienie tego, co ludzie potrafili robić, z tym, czym rzeczywiście chcieli się zajmować, generujący mapę cieplną, która sprawiała, że decyzje dotyczące przenoszenia pracowników były bardziej humanitarne i strategiczne.
Nie było to rozwiązanie oparte na AI. Był to formularz Microsoft Forms. Jednak jego podstawowa logika była trafna, zastosowanie rzeczywiste, a Satterfield widziała, że działa.
„Duzi dostawcy próbują to robić, ale jak dotąd nikomu tak naprawdę nie udaje się robić tego dobrze, a wiele firm nie ma przeznaczonego budżetu na tego rodzaju technologię poza podstawowym systemem HRIS” — powiedziała.
Grupa dostrzegła możliwość. Co, gdyby stworzyli wersję natywnie opartą na AI? Taką, która byłaby konwersacyjna zamiast klinicznej, zorientowana na przyszłość zamiast na zgodność z przepisami i wyceniona z myślą o pojedynczych liderach HR, a nie zamknięta za umowami dla przedsiębiorstw?
Sposób, w jaki HR rozmawia z HR o HR, jest zasadniczo inny. Może to stanowić realną wartość, a większość narzędzi całkowicie to pomija.
Melina Gillies · Dyrektorka ds. pracowników, Flex Networks
Fisher, słuchając, jak grupa analizuje możliwości, przedstawił spostrzeżenie, które na nowo określiło potencjał projektu. Doświadczył obu krańców spektrum HR: podejścia skoncentrowanego najpierw na zgodności, ramach i transakcjach oraz rzadszego praktyka stawiającego ludzi na pierwszym miejscu, który rozmawiał z nim „jak człowiek, który czuł, że jest po mojej stronie.”
„Język tego drugiego rodzaju” — powiedział — „nigdy nie brzmiał tak, jakby pochodził z ram opracowanych dekady temu. Po prostu dobrze się go słuchało.”
Gillies podchwyciła ten wątek. Jej zdaniem tym, co wyróżniałoby ich narzędzie, był ton i struktura. Co, gdyby mogło odtworzyć sposób, w jaki specjaliści HR naprawdę rozmawiają ze sobą na konferencji, między sesjami, nieoficjalnie? Co, gdyby rozumiało „polityczną zręczność” nie jako pole wyboru, lecz jako złożone, budzące spory i zależne od sytuacji pojęcie, o którym doświadczeni praktycy spierają się między sobą?
Taki był kierunek: narzędzie do oceny przed zatrudnieniem, zaprojektowane dla liderów HR i pozyskiwania talentów, którzy potrzebują lepszego sposobu oceniania kandydatów na rekruterów przed ich zatrudnieniem. Nie quiz osobowościowy ani analiza CV, lecz ustrukturyzowana, konwersacyjna diagnoza, która mogłaby powiedzieć kierownikowi ds. rekrutacji, czy osoba siedząca naprzeciwko rzeczywiście wie, jak wykonywać tę pracę. Narzędzie, które przypominałoby mniej ocenę wyników pracy, a bardziej rozmowę z kimś, kto zna rekrutację od podszewki.
Moment olśnienia
Podczas trzeciej sesji grupa była już głęboko zaangażowana w projektowanie architektury narzędzia: w to, jakie kompetencje oceniać, jak uporządkować je na poszczególnych poziomach oraz jak uwzględnić różnicę między tym, co ludzie mówią, że potrafią, a tym, co rzeczywiście potrafią.
Krytyka istniejących ram wyszła od Gillies, która opisała model kompetencji SHRM jako „bardzo tradycyjny i pod pewnymi względami bardzo skupiony na przeszłości”. Jej zdaniem zawód ten wciąż znajdował się w stanie „postindustrialnego kaca” — opierał się na zgodności z przepisami i hierarchii oraz był zaprojektowany dla świata, który już odchodził.
Ich narzędzie musiało być ukierunkowane na coś innego — nie na to, co liderzy HR musieli wiedzieć, lecz na to, co musieli potrafić robić.
Czy jesteś gotów porozmawiać z dyrektorem generalnym o jego wynikach? Jeśli nie, nie jesteś ekspertem w prowadzeniu trudnych rozmów.
Erin Turnmeyer · Wiceprezes ds. operacji personalnych
Turnmeyer miała wyrazisty przykład. Niedawno zdawała egzamin SPHR. Rzeczy, których musiała się nauczyć — przepisy, definicje proceduralne, zasady klasyfikacji — były rzeczami, które każdy kompetentny specjalista HR po prostu by sprawdził.
Umiejętności twarde nie były materiałem certyfikacyjnym. Chodziło o takie rzeczy jak: Czy potrafisz usiąść naprzeciwko dyrektora generalnego i powiedzieć mu coś, czego nie chce usłyszeć? Czy potrafisz działać w interesie pracownika, gdy uzasadnienie biznesowe jest niejednoznaczne? Zapamiętywanie kodeksów pracy nie daje odpowiedzi na te pytania.
Fisher poszedł dalej. Przez lata zajmował się zarządzaniem zmianą i odkrył, że najbardziej predyktywną zmienną określającą zdolność organizacji do przeprowadzania transformacji nie była żadna konkretna umiejętność. Była nią relacja danej osoby z niejednoznacznością.
To, jak komfortowo ktoś czuje się w sytuacji dyskomfortu — albo ogólnie w obliczu tempa zmian — jest tak dobrym wskaźnikiem jego zdolności do funkcjonowania w tym nowym świecie.
Tim Fisher · Dyrektor ds. AI, Black and White Zebra
Potem pojawiło się to, co grupa później nazwała tajnym składnikiem.
Gillies zadał pytanie. A gdyby narzędzie zawierało mechanizm weryfikacji krzyżowej? Jeśli ktoś oceniłby siebie jako eksperta w zarządzaniu konfliktami, ale następnie w odpowiedzi w języku naturalnym na dodatkowe pytanie opisałby sytuacje, które brzmiałyby jak wszystko, tylko nie jak przejaw ekspertyzy, czy sztuczna inteligencja mogłaby to oznaczyć? Czy mogłaby delikatnie zasugerować, że w tym obszarze może istnieć luka?
„To jest moment olśnienia” — powiedziała Turnmeyer.
Satterfield zauważyła, że każdy, kto pracował z inwentaryzacjami umiejętności, spotkał się z różnymi wersjami tego samego problemu. Ludzie często oceniają siebie zupełnie inaczej, niż sugerowałyby ich rzeczywiste doświadczenie lub zachowanie.
Wartość narzędzia nie wynikałaby z rejestrowania tego, co ludzie sądzą na swój temat. Wynikałaby z kalibracji — delikatnego, opartego na danych napięcia między samooceną a wykazanymi zdolnościami.
Ocena nie byłaby tylko lustrem. Byłaby czymś bardziej w rodzaju „lustereczko, powiedz przecie” niż większość ocen pracowniczych, do których ludzie są przyzwyczajeni.
Realne wyzwania związane z budowaniem
Nic z tego nie było łatwe. A grupa wiedziała o tym od początku.
Najtrudniejsze i najbardziej uporczywe wyzwanie nie miało charakteru technicznego. Dotyczyło zakresu. Każda sesja generowała dziesięć nowych kierunków, z których każdy był naprawdę wartościowy i każdy mógł całkowicie pochłonąć projekt. Turnmeyer nazwała ten problem na wczesnym etapie i często do niego wracała.
„Dopilnujcie, żeby pierwsza rzecz działała prawidłowo, bo inaczej zakres będzie się tak wymykał spod kontroli, że nie zdołacie tego stworzyć” — powiedziała.
Satterfield przedstawiła grupie zasadę przewodnią: różnicę między minimalnym produktem wykonalnym a minimalnym produktem wartościowym. Produkt wykonalny działa. Produkt wartościowy sprawia, że ludzie chcą do niego wracać.
Na rynku nasyconym narzędziami oceny interfejs, który nie dostarcza czegoś znaczącego przy pierwszym użyciu, nie dostanie drugiej szansy na poprawę. Poprzeczką nie jest funkcjonalność. Jest nią wartość.
Jeśli produkt nie zapewni wystarczającej wartości przy pierwszym użyciu, użytkownicy prawdopodobnie nie wrócą później, żeby sprawdzić, czy coś się poprawiło.
Kelly Satterfield · Liderka HR i konsultantka
Istniały również praktyczne ograniczenia, które dobrze zna każdy, kto próbował tworzyć coś poza zespołem programistycznym: wdrażanie, infrastruktura płatności, integracja z istniejącymi systemami, a także okna kontekstowe zamykające się w połowie sesji i wymazujące godziny produktywnej pracy.
Wczesna wersja odzwierciedlała główny przepływ narzędzia. Kandydat na stanowisko rekrutera przesyła życiorys, narzędzie tworzy wstępny profil umiejętności, a następnie przeprowadza kandydata przez serię konwersacyjnych pytań zaprojektowanych tak, aby skalibrować i dodać kontekst oraz głębię do początkowej oceny.
Na końcu lider ds. rekrutacji otrzymuje obraz tego, jak kandydat rzeczywiście wypada na tle zdefiniowanych ram kompetencji.
Fisher skonfigurował podstawowe środowisko budowania w Lovable — narzędziu do tworzenia aplikacji AI bez kodowania, które generuje narzędzia dostępne publicznie za pomocą rozmowy, bez uzależniania użytkowników od konkretnego LLM — dzięki czemu architektura techniczna mogła nadążać za sposobem myślenia grupy, nie stając się własnym wąskim gardłem.
Od projektu do budowy
Podczas czwartej sesji grupa nie projektowała już abstrakcyjnego narzędzia. Budowała je i odkrywała — jak zawsze odkrywają to twórcy — że odległość między pomysłem a wykonaniem jest dokładnie tym miejscem, w którym zachodzi prawdziwa nauka.
Fisher przygotował podstawową niestandardową wersję GPT przed rozpoczęciem rozmowy, wyposażoną w instrukcje, wstępne ramy kompetencji oraz zalążki logiki konwersacyjnej, które opracowali podczas wcześniejszych sesji. Plan zakładał, że wszyscy uzyskają do niej dostęp, będą wspólnie ją instruować i rozpoczną kalibrowanie jej głosu oraz zachowania w czasie rzeczywistym. Plan natychmiast zderzył się z rzeczywistością.
Udostępniony link nie działał u nikogo poza mną. Uprawnienia w obszarze roboczym, specyfika platformy i sposób, w jaki ChatGPT obsługuje dostęp zewnętrzny, pochłonęły pierwszą czwartą część sesji.
To była drobna frustracja, dokładnie tego rodzaju, który nigdy nie trafiłby do zapowiedzi produktu, a jednak okazała się pouczająca. Narzędzia, których praktycy faktycznie używają do tworzenia rzeczy, nie zachowują się jak wersje demonstracyjne.
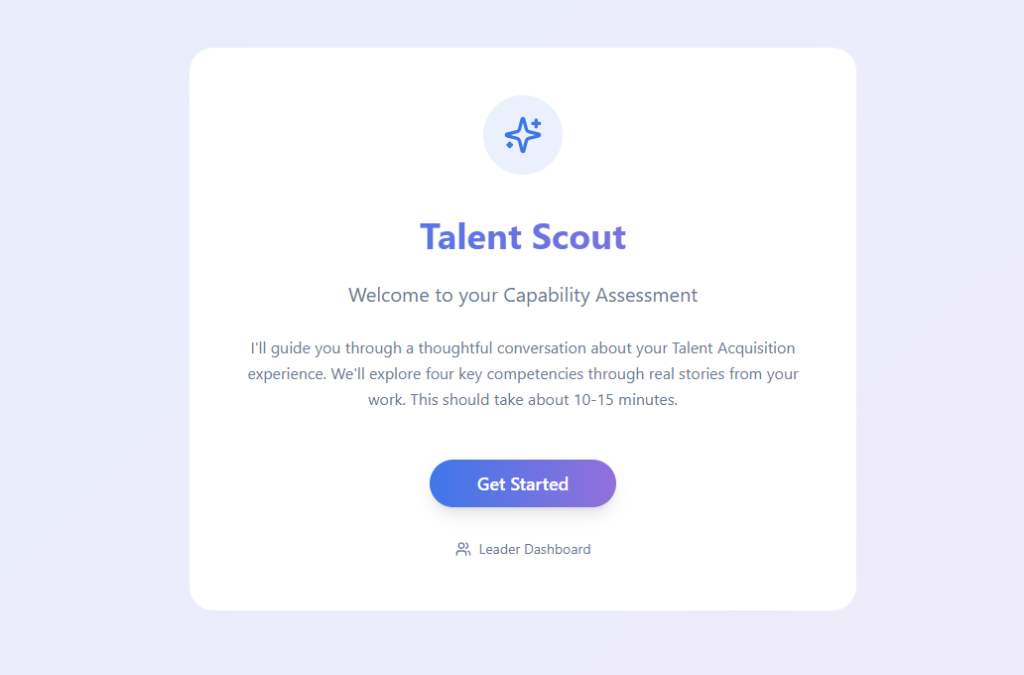
Ten zrzut ekranu pokazuje, jak miał ostatecznie wyglądać ekran powitalny narzędzia stworzonego przez grupę, nazwanego Talent Scout.
Gdy wszyscy patrzyli już na ten sam ekran, wydarzyło się coś ciekawszego. Podczas gdy grupa wciąż omawiała, jaką formę powinny przyjąć definicje kompetencji, Gillies otworzyła Claude'a w osobnym oknie i przekształciła tabelę ocen w uporządkowany JSON — na żywo, podczas rozmowy.
„Używam Claude'a, ponieważ lepiej się do tego nadaje niż ChatGPT” — powiedziała bez zbędnych formalności. Kilka minut później wrzuciła sformatowany plik na czat grupowy. Nikt nie zatrzymał się, by to skomentować. Po prostu ruszyli dalej.
Ten rodzaj rozwiązywania problemów w biegu — przekształcanie wąskiego gardła w rozwiązany problem bez robienia z niego głównego tematu spotkania — odróżnia praktyków, którzy naprawdę przyswoili te narzędzia, od tych, którzy wciąż uczą się z nich korzystać.
Kto ma ostatnie słowo
Satterfield zadała pytanie, które miało istotne konsekwencje zarówno dla architektury narzędzia, jak i dla jego późniejszego odbioru: czy AI wystawia ostateczną ocenę, czy potwierdza ją użytkownik?
Ta różnica nie jest wyłącznie kwestią wyglądu. Jeśli narzędzie wydaje werdykt, taki jak „Na podstawie Twoich odpowiedzi jesteś na poziomie 2 w zakresie ukierunkowania na kandydatów”, stawia AI w roli autorytetu. Jeśli zamiast tego przedstawia wstępną ocenę i zachęca użytkownika do zgłoszenia zastrzeżeń, cała dynamika ulega zmianie. Ocena staje się współpracą, a nie wartościowaniem. Użytkownik jest uczestnikiem procesu, a nie jego przedmiotem.
„Czy akceptujesz tę informację zwrotną?” — powiedział Turnmeyer, gdy pomysł zaczął nabierać kształtu. „Naprawdę mi się podoba”.
Gillies rozbudowała tę logikę. Jeśli użytkownik nie akceptuje oceny, narzędzie pyta, co wydaje mu się nieprawidłowe, a następnie wykorzystuje odpowiedź do ponownej kalibracji lub delikatnego potwierdzenia swojej oceny, przechodząc przez dowody.
To właśnie taka konwersacyjna wymiana tworzy poczucie bezpieczeństwa psychologicznego, którego narzędzie potrzebuje, aby być naprawdę użyteczne. Ludzie nie zmieniają się pod wpływem informacji zwrotnej, której nie ufają. Uzyskanie poparcia nie jest miękką funkcją — to cały mechanizm.
Pierwszy prawdziwy test
Postanowili przetestować prototyp na żywo. Turnmeyer zgłosiła się do udzielenia celowo zdawkowej odpowiedzi na jedno z pytań oceniających — takiej, jakiej mógłby udzielić niezainteresowany kandydat lub rozkojarzony pracownik.
Opisała kłótnię z przełożonym dotyczącą rozbieżności w wynagrodzeniu, utratę kandydata i całkowity brak wiedzy o tym, jaki był rezultat. Był to odpowiednik sytuacji, w której na pytanie, dlaczego chcesz pracować w HR, odpowiadasz: „Po prostu naprawdę lubię ludzi”.
Narzędzie natychmiast dokonało oceny. Przypisało poziom. Było zachęcające. Było również błędne — nie pod względem faktów, lecz dlatego, że zadziałało przedwcześnie. Przyjęło założenia dotyczące tego, co sugerowała odpowiedź, zamiast poprosić o dodatkowy kontekst potrzebny do dokonania trafnej oceny.
Jeśli zamierzasz przyznać komuś coś innego niż „spełnia oczekiwania”, musisz podać szczegółowe przykłady. AI powinno stosować wobec siebie ten sam standard.
Erin Turnmeyer · wiceprezes ds. operacji personalnych
Turnmeyer bezpośrednio odwołała się do swojej praktyki przeprowadzania ocen pracowniczych. Od dawna wymagała od menedżerów przedstawienia konkretnych dowodów przed przyznaniem komukolwiek oceny powyżej lub poniżej poziomu „spełnia oczekiwania”.
Ta sama dyscyplina powinna dotyczyć narzędzia. Zanim przypisze poziom, powinno zasłużyć na prawo do tego, zadając pytania, które sprawią, że ocena będzie możliwa do obrony. Po raz kolejny to wiedza specjalistyczna z zakresu HR obecna w pomieszczeniu czyniła AI lepszym — a nie odwrotnie.
Satterfield dodała komplikację, którą narzędzie pominęło. Zdawkowa odpowiedź mogła odzwierciedlać politykę firmy, a nie umiejętności.
Jeśli menedżer rzeczywiście ustalił sztywny limit wynagrodzenia, bardziej zdecydowane negocjacje nie zmieniłyby wyniku. Narzędzie oceniło osobę, choć powinno było pytać o sytuację. Pytania doprecyzowujące nie były elementem kosmetycznym. To one miały oddzielić użyteczną ocenę od oceny opartej na zbyt daleko idących założeniach.
Turnmeyer potraktowała zadanie napisania instrukcji jako pracę domową: jak nakłonić narzędzie, by zadawało pytania doprecyzowujące we właściwych momentach, nie sprawiając przy tym, że każda interakcja będzie przypominała przesłuchanie?
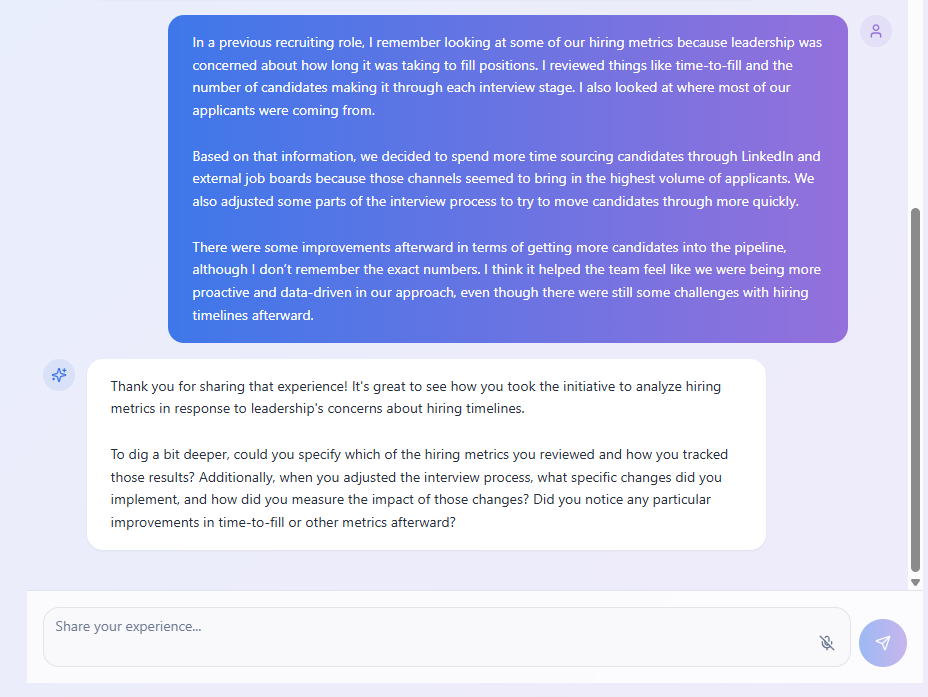
Ten zrzut ekranu pokazuje przykład tego, jak działałby finalny produkt: zadawałby pytania doprecyzowujące i skłaniał kandydata do wejścia w większą szczegółowość.
To trudniejszy problem, niż mogłoby się wydawać, a ona doskonale zdawała sobie sprawę, że poprzeczka została zawieszona wyjątkowo wysoko.
"To musi być lepsze od człowieka" — powiedziała. "Taki jest standard."
Testowanie jako dyscyplina
Sesja przyniosła również jeden z bardziej praktycznych i użytecznych wniosków metodologicznych z całej grupy. Kiedy Satterfield zapytała, jak grupa zazwyczaj testowała tego rodzaju narzędzia, zarówno Turnmeyer, jak i Gillies odpowiedziały w sposób, który ujawnił coś ważnego na temat tego, jak w praktyce wygląda rygorystyczne testowanie.
W przypadku swojego narzędzia do rekomendowania świadczeń, które musiało dokładnie wskazywać, czy konkretne leki były objęte firmowym planem zdrowotnym, Turnmeyer celowo testowała przypadki brzegowe. Nie oczywiste leki ani te popularne, z którymi model wielokrotnie zetknął się podczas treningu. Testowała te mało znane, należące do kategorii, które z największym prawdopodobieństwem prowadziły do pewnej siebie halucynacji.
"Poszłam i przetestowałam te niepopularne leki" — powiedziała — "bo Claude pokazał mi, co robi podczas budowania narzędzia."
Taki poziom celowego, konfrontacyjnego podejścia do testowania jest rzadkością wśród twórców wywodzących się spoza środowiska inżynieryjnego. Jest też dokładnie tym, co odróżnia narzędzia zdobywające zaufanie od tych, które po kompromitującej porażce są po cichu porzucane.
Usuwanie tego, co już zbudowano
Sesja podsumowująca tuż przed świętami rozpoczęła się od pytania, które trudniej było zadać, niż mogłoby się wydawać: do czego właściwie służy funkcja przesyłania CV?
Gillies je zadała. Ocena wymagała od użytkowników uważnego zastanowienia się nad własnymi możliwościami. Czy CV dostarczało informacji, których użytkownik nie mógł przekazać bardziej bezpośrednio, po prostu odpowiadając na pytania? Nikt w grupie nie miał pewności, że tak było. Pierwotnym zamiarem było zaoszczędzenie czasu, podobnie jak w przypadku parsera CV, ale nie byliśmy już przekonani, że funkcja rzeczywiście spełniała to zadanie.
Uzgodnili, że ją usuną.
W tworzeniu produktów zdarza się to rzadziej, niż mogłoby się wydawać. Grupa poświęciła funkcji przesyłania sporo czasu — budując ją, testując i obserwując, jak CV Satterfield było analizowane i oceniane z błędami. Usunięcie jej wymagało odrzucenia logiki kosztów utopionych, która sprawia, że zespoły wciąż rozbudowują rzeczy, w które już zainwestowały.
Zacznij od celu i określ, jak powinien wyglądać dobry rezultat. Jeśli nie potrafisz wyjaśnić, do czego służy dana funkcja, nie możesz jej bronić.
Turnmeyer przedstawiła podobny argument dotyczący metodologii. Z perspektywy czasu uważała, że mogli działać szybciej, gdyby w pełni zdefiniowali zachowanie narzędzia, zanim napisali choćby jedno polecenie. Pracowali w sposób przypominający model zwinny — budowanie, testowanie, poprawianie — podczas gdy złożoność tworzonego rozwiązania mogła wymagać raczej podejścia kaskadowego: najpierw dopracować specyfikację, a potem na jej podstawie budować.
Wnioski te nasunął jej 130-stronicowy dokument projektowy dotyczący innego narzędzia, które stworzyła. Kompletna specyfikacja nie mówi tylko, co należy zbudować. Mówi również, czego nie budujemy — a to okazuje się równie przydatne.
Gillies precyzyjniej określiła główny problem produktu. Niezależnie od tego, co narzędzie pokazywało na ekranie, musiało iść dalej. Ocena, która ujawnia dane, to nie to samo co narzędzie mówiące, co należy z nimi zrobić. Ta luka między wynikiem a działaniem to miejsce, w którym narzędzia diagnostyczne po cichu przestają być użyteczne — i luka, której większość z nich nigdy nie zamyka.
Budowanie w pojedynkę
W styczniu Satterfield sama zajmowała się większością prac, ponieważ pozostałych członków grupy zbyt mocno pochłaniała praca od dziewiątej do siedemnastej i zabierała zbyt wiele czasu, by zostawić go jeszcze na projekt. W końcu nikt nie otrzymywał za to wynagrodzenia.
Usunęła funkcję przesyłania CV, zgodnie z ustaleniami grupy. Dodała wprowadzanie głosowe — użytkownicy mogli teraz odpowiadać na pytania oceny, mówiąc zamiast pisać, co otworzyło możliwość udzielania bardziej konwersacyjnych odpowiedzi, trudniejszych do zmanipulowania niż pole tekstowe.
Używała ChatGPT do generowania syntetycznych odpowiedzi testowych ("Jestem początkującym rekruterem, który jest dobry w tym i słaby w tamtym, podaj mi odpowiedzi"), a następnie przełączała się na Lovable, wprowadzała te odpowiedzi i obserwowała, jak narzędzie je ocenia.
Panel lidera stanowił drugą połowę logiki narzędzia — widok, z którego korzystałby dyrektor ds. pozyskiwania talentów lub dyrektor HR, aby zobaczyć, jak kandydat wypadł w ocenie, gdzie występowały luki oraz jak jego kompetencje mogłyby uzupełniać mocne strony i potrzeby istniejącego zespołu.
To sprawiało, że struktura organizacyjna stawała się realnym problemem, ponieważ narzędzie musiało wiedzieć, kto kogo ocenia i kto ma uprawnienia do wglądu w wyniki.
Satterfield próbowała poradzić sobie z tym, prosząc użytkowników o podanie imienia i nazwiska, stanowiska oraz imienia i nazwiska przełożonego (wobec braku integracji danych). Ta logika nie sprawdzała się jednak w często spotykanym scenariuszu: dyrektor ds. pozyskiwania talentów chciał wysłać ocenę do szerszej organizacji rekrutacyjnej, obejmującej zarówno bezpośrednie, jak i pośrednie relacje podległości. Logika mapowania struktury organizacyjnej nie była wystarczająco szczegółowa, aby uwzględnić taką strukturę.
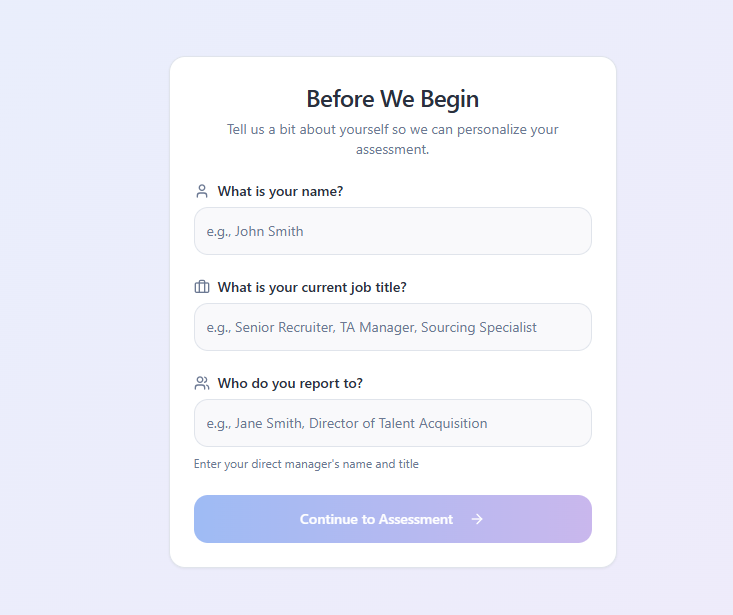
Teoretycznie informacje te dawałyby narzędziu szerszy kontekst dotyczący roli osoby wypełniającej ocenę, ale gromadzenie większej ilości danych dodatkowo komplikowało sytuację.
Turnmeyer rozwiązała już podobną wersję tego problemu w innym kontekście. Narzędzie do zarządzania efektywnością pracy, które stworzyła dla własnej firmy, działało w oparciu o Google Sheets, Slacka i Claude'a. Google Sheets przechowywało dane. Slack był interfejsem, z którym kontaktowali się pracownicy. Claude zajmował się analizą i generowaniem informacji zwrotnych.
Architektura była prostsza, niż mogło się wydawać: arkusz kalkulacyjny zawierający imię i nazwisko, adres e-mail, poziom stanowiska oraz nazwę stanowiska. Osobna karta porównująca poziom stanowiska z kompetencjami.
„Dział bezpieczeństwa w mojej firmie chciał przejrzeć moje narzędzie” — powiedziała grupie. „Powiedziałam, że jest przechowywane w Google Docs. Odpowiedzieli: «Och, to takie proste»”.
Proste, ale Turnmeyer dowiedziała się o tym dopiero podczas budowania. Trzy tygodnie wcześniej nie wiedziała, że istnieje rejestrowanie — funkcja, która zapisuje postępy użytkownika, dzięki czemu narzędzie nie resetuje się, gdy ktoś odchodzi na chwilę i wraca.
„Klęłam na Claude'a” — powiedziała — „dopóki nie powiedział mi, że istnieje rejestrowanie.
Właśnie tego naprawdę uczy budowanie. Nie tego, czego planowaliśmy się nauczyć, lecz tego, o czym nie wiedzieliśmy, że musimy to wiedzieć.
Pytanie kryjące się pod spodem
W pewnym momencie styczniowego spotkania rozmowa dotarła do pytania, wokół którego krążyła od miesięcy.
Grupa nieustannie omawiała architekturę, uprawnienia, przechowywanie danych i panele — wszystkie te kwestie były realnymi problemami. Pod nimi krył się jednak bardziej fundamentalny problem. Co właściwie próbowali zbudować i dla kogo?
Narzędzie, zgodnie z pierwotną koncepcją, było narzędziem diagnostycznym do selekcji — czymś, co lider ds. pozyskiwania talentów mógł wysłać kandydatowi lub pracownikowi wewnętrznemu, aby ocenić, czy jego rzeczywiste kompetencje odpowiadają temu, co znalazło się w jego CV, i uzyskać ten obraz przed podjęciem decyzji o wyborze.
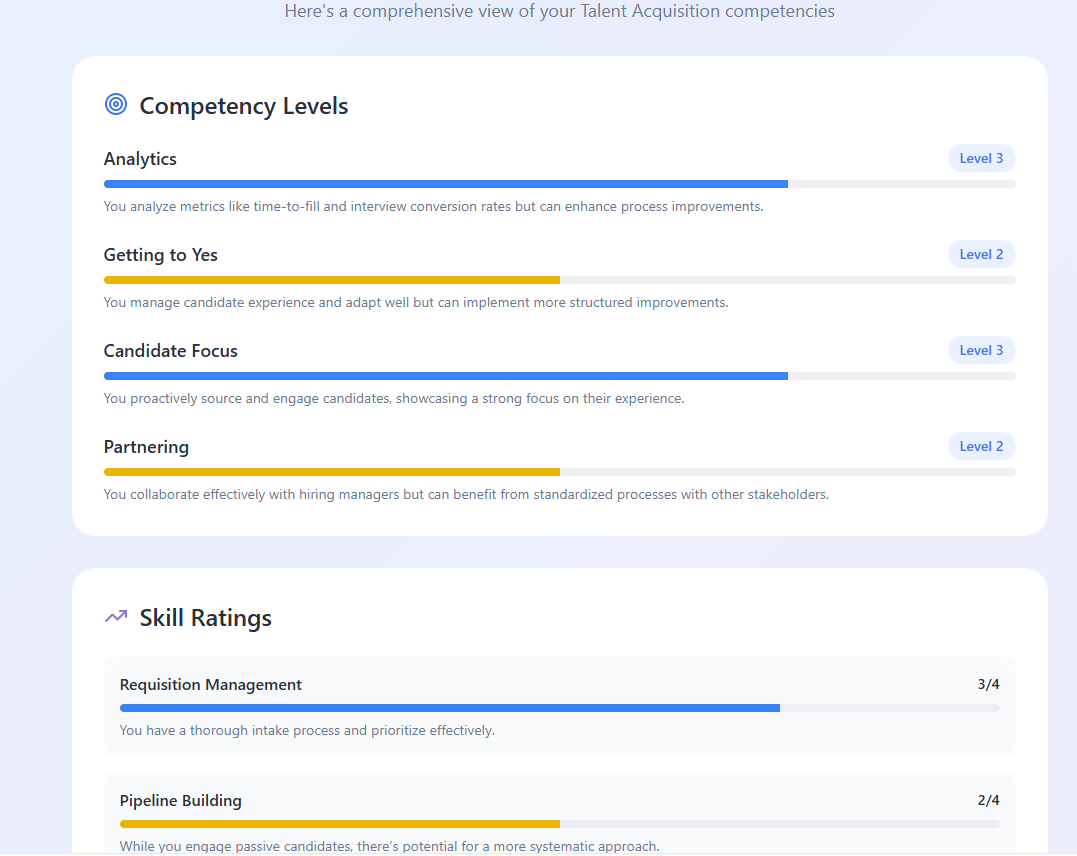


To, co tutaj widzisz, to wybór zrzutów ekranu przedstawiających rodzaj raportu, który narzędzie wygenerowało dla osoby biorącej udział w rozmowie. Dla osoby oceniającej panel z aktualnymi mocnymi stronami zespołu pomaga skoncentrować się na tym, co należy ocenić u rozmówcy, aby sprawdzić, czy odpowiada on słabym stronom zespołu ds. pozyskiwania talentów.
Ten podstawowy cel się nie zmienił. Jednak każda praktyczna decyzja, którą podejmowali — dodanie panelu lidera, rozważanie modeli subskrypcji, opracowanie procesu logowania — kierowała ich ku czemuś bardziej złożonemu.
Panele działające w czasie rzeczywistym oznaczały stały dostęp, co oznaczało opłaty subskrypcyjne, a to z kolei przybliżało ich do rodzaju narzędzi korporacyjnych, na które wiele organizacji ma trudności ze znalezieniem środków lub skutecznym wdrożeniem.
„Nie próbujemy zostać dostawcą systemów HCM” — powiedziała Satterfield.
Turnmeyer szczerze powiedziała, jakie jest jej stanowisko.
„Moim zamiarem było po prostu nauczyć się czegoś nowego”.
Nie oznaczało to wycofania się z projektu. Był to zgodny z rzeczywistością opis tego, co eksperyment już jej przyniósł. Nauczyła się kilku nowych rzeczy i już pracowała nad budową nowego narzędzia do zarządzania efektywnością pracy, wykorzystując wnioski zebrane przez grupę.
Nie musiała przekształcać narzędzia grupy w produkt, aby odnieść z niego realną korzyść.
Na tym etapie moje zainteresowanie miało przede wszystkim charakter redakcyjny. Chciałem mieć historię do opowiedzenia i coś, co ludzie mogliby obejrzeć — nie produkt subskrypcyjny, lecz demonstrację, która skłoniłaby praktyków HR do refleksji i być może do zbudowania podobnego narzędzia.
Napisanie tego artykułu było częścią tego planu. Czy mógłbym stworzyć przewodnik do pobrania? A w dalszej perspektywie wydarzenie na żywo, podczas którego grupa mogłaby omówić to, co zrobiła, pozwolić publiczności wejść w interakcję z narzędziem i nagrać rozmowę jako podcast? Miałem wiele pomysłów, ale czas na ich realizację, gdy cele nowego roku zaczęły się piętrzyć przed nami wszystkimi, stawał się coraz krótszy.
Zainteresowanie Satterfield było najbardziej ukierunkowane komercyjnie i jasno o tym mówiła. Docelowo chciała przekształcić narzędzie w produkt. Nie zamierzała robić tego sama. Była jednak gotowa nadal budować coś, co pewnego dnia można byłoby sprzedawać.
Ta trójstronna rozbieżność intencji — nauka, opowiadanie historii, produkt — jest prawdopodobnie nieodłączną cechą każdej takiej grupy. Szczera rozmowa na ten temat w styczniu była bardziej pomocna niż udawanie, że wszyscy od początku chcieli tego samego.
Demonstracja jako odpowiedź
Kwestia tego, jak pozwolić ludziom wypróbować narzędzie, pozostawała nierozstrzygnięta od czasu uruchomienia przesyłania CV. Testowanie z prawdziwymi użytkownikami jest wartościowe, ale stwarza własne problemy. Narzędzie musi działać spójnie, użytkownicy muszą mieć wystarczający kontekst, aby wiedzieć, co robią, a po złym pierwszym doświadczeniu trudno odzyskać zaufanie.
Turnmeyer zaproponowała najprostsze rozwiązanie, jakie grupa dotąd rozważała.
Oglądała nagrania demonstracyjne — krótkie prezentacje trwające minutę lub dwie, pokazujące działanie narzędzia bez konieczności faktycznego korzystania z niego. Zasugerowała, że to może wystarczyć. Ludzie mogliby zobaczyć narzędzie w działaniu, zrozumieć, co robi i dlaczego, a następnie wyjść z poczuciem, że sami byliby w stanie to zrobić.
Nie musieliby przechodzić przez logowanie, dostarczać schematu organizacyjnego ani utknąć w sytuacji, gdy pytanie oceniające nie pasuje do ich sytuacji.
Informacja zwrotna, którą otrzymuję na temat wielu pisanych przeze mnie artykułów, jest taka, że ludzie tak naprawdę nie chcą kopiować i wklejać dokładnie tego samego. Chcą tylko wiedzieć, że są w stanie to zrobić.
Erin Turnmeyer · Wiceprezeska ds. operacyjnych HR
Ta obserwacja wskazuje na coś istotnego w sposobie, w jaki osoby zajmujące się HR odnoszą się obecnie do narzędzi AI. Przepaść, z którą mierzy się wiele z nich, nie przebiega między wiedzą o tym, że coś istnieje, a korzystaniem z tego. Chodzi raczej o różnicę między przekonaniem, że potrafią zrobić coś takiego, a brakiem takiego przekonania.
Demonstracja pokazująca osoby zajmujące się HR podczas tworzenia własnego narzędzia odpowiada na inne pytanie niż gotowy produkt — nie „czy to narzędzie jest dobre?”, lecz „czy ktoś taki jak ja mógłby je stworzyć?”
Pomysł spotkał się z dobrym przyjęciem. Rozwiązywał problemy związane z testowaniem, zmniejszał złożoność udostępniania czegoś, co nie było jeszcze gotowe do użycia produkcyjnego, i utrzymywał nacisk tam, gdzie grupa od początku chciała go kłaść — na procesie i sposobie myślenia, a nie tylko na rezultacie.
Czego nauczył nas eksperyment: przewodnik dla twórców narzędzi HR
- Zacznij od problemu, nie od technologii. Wczesny entuzjazm grupy wobec analizy nastrojów był szczery, ale odciągnął ją od problemu łatwiejszego do rozwiązania i bardziej wartościowego. Zwrot w stronę mapowania umiejętności zadziałał, ponieważ punktem wyjścia był rzeczywisty przypadek użycia, który został już sprawdzony w praktyce.
- Rozwiązanie szyte na miarę wygrywa z ogólnym. Każdy uczestnik zetknął się z ograniczeniami korporacyjnych platform HR. Narzędzia stworzone z myślą o konkretnych kontekstach — rekomendator świadczeń Turnmeyer i mapa cieplna Satterfield — przewyższyły gotowe alternatywy. Argumenty za budowaniem własnych rozwiązań są silniejsze niż kiedykolwiek, a bariery niższe.
- Weryfikacja krzyżowa jest sednem całej sprawy. Samooceny są tylko tak dobre, jak samoświadomość ludzi, a ta jest powszechnie uznawana za zawodną. Prawdziwa wartość narzędzia polega na jego zdolności do badania, kwestionowania i delikatnego korygowania — a nie jedynie rejestrowania tego, co ludzie sądzą o sobie.
- Minimum wartościowe, nie minimum wykonalne. Jeśli pierwsza wersja nie dostarcza czegoś, co sprawia, że użytkownik chce wrócić, plan rozwoju nie ma znaczenia. Projektuj z myślą o pierwszym wrażeniu, nie o piątym.
- Akceptacja ma charakter strukturalny, a nie miękki. Kwestia tego, czy AI wystawia ostateczną ocenę, czy użytkownik ją zatwierdza, nie jest szczegółem doświadczenia użytkownika. Określa, czy narzędzie jest autorytetem, czy współpracownikiem, a to rozróżnienie kształtuje wszystko, co dotyczy jego odbioru i wykorzystywania.
- Usuwaj funkcje, które już zbudowałeś. Myślenie o kosztach utopionych sprawia, że zespoły dodają kolejne elementy do rzeczy, w które zainwestowały, długo po tym, jak przestały one zasługiwać na swoje miejsce. Jeśli nie potrafisz wyjaśnić, do czego służy dana funkcja, to jest twoja odpowiedź. Usunięcie jej to dyscyplina produktowa, a nie porażka.
- Testuj konfrontacyjnie i wcześnie. Znajdź osoby, które powiedzą ci, że narzędzie jest złe. Podaj mu najgorsze rozsądne dane wejściowe, jakie potrafisz sobie wyobrazić, i zobacz, co zrobi. Uwzględnij przypadki skrajne, zanim dopracujesz te typowe. Wiarygodność narzędzia zależy od tego, jak radzi sobie w sytuacjach, do których nie zostało zaprojektowane.
- Narzędzie powinno zasłużyć na prawo do oceniania. Wystawianie oceny przed zadaniem wystarczającej liczby pytań to przesada, a nie efektywność. Pytania doprecyzowujące sprawiają, że ocena staje się możliwa do obrony, a możliwość jej obrony sprawia, że informacja zwrotna zostaje przyjęta.
- Szczerze określ, po co wszyscy tu są. Rozbieżne intencje w grupie nie są problemem, którym trzeba zarządzać — są informacją. Ujawnienie ich na wczesnym etapie oszczędza wszystkim budowania w kierunku celu, z którym w rzeczywistości zgadza się tylko część grupy.
- Najtrudniejsze rozmowy są najważniejsze. Grupa zbudowała narzędzie do oceny umiejętności HR, a przy okazji odbyła jedną z najbardziej szczerych rozmów o ograniczeniach HR, jakie ktokolwiek z jej członków potrafił sobie przypomnieć. Ta rozmowa — o ramach ukierunkowanych na przeszłość, o różnicy między wiedzą egzaminacyjną a osądem sytuacyjnym — była częścią produktu w takim samym stopniu jak samo narzędzie.
Sesje, które zaczęły się jako zobowiązanie do czterech rozmów, przeciągnęły się na zimę, a następnie na nowy rok. Prototyp wciąż ewoluował. Intencje osób, które go zbudowały, uległy doprecyzowaniu w sposób, którego nie dało się łatwo rozstrzygnąć.
Satterfield wciąż budował. Turnmeyer wykorzystała to, czego się nauczyła, i zastosowała to gdzie indziej. Gillies zmusił grupę do większej dyscypliny w określaniu, co właściwie miało robić narzędzie. Ja spisywałem całą tę historię.
Turnmeyer powiedziała na początku tego procesu coś, co pozostało prawdą: budowała nie dlatego, że ją o to poproszono, lecz dlatego, że musiała zrozumieć.
To zrozumienie tego, co narzędzia AI faktycznie robią, w czym się mylą i czego potrzeba, aby stały się użyteczne, nie było dostępne podczas żadnej sesji konferencyjnej ani prezentacji dostawcy. Wynikało z decyzji podejmowanych przez grupę, z funkcji, z których zrezygnowali, oraz z chwil, gdy narzędzie błędnie oceniło kogoś i musieli ustalić dlaczego.
Najbardziej użyteczne rzeczy stworzone przez grupę nie znajdowały się w prototypie. Tkwiły w rozumowaniu, które za nim stało.

