

Vad dina agenter inte kan slutföra utan dig
Grundläggande förändring: Upwork säljer nu leverans av arbete, där system kombinerar människor och maskiner för att uppnå resultat i stället för att fylla roller.
Begränsningar i riktmärket: Upworks automatiseringsriktmärke testade utvalda jobb med låg komplexitet, så resultaten kan inte representera merparten av arbetet på plattformen.
Mänskligt värde: Mänsklig återkoppling förbättrade agenternas slutförande, men krävde betydligt mer tid och ledde aldrig till tillförlitlig framgång för alla jobb.
Verifieringsgapet: Automatisering fungerar bäst när resultaten kan kontrolleras objektivt; arbete som kräver mycket omdöme och sträcker sig över flera funktioner behöver fortfarande mänskligt ansvar.
Affärstestet: Mät automatisering utifrån accepterade resultat, prissätt expertgranskning som produktion och skydda roller på mellannivå som utvecklar framtida omdöme.
Upwork har slutat kalla sig en talangmarknadsplats. Nu är termen ”arbetsleveransplattform”, och förändringen handlar om mer än positionering.
På en marknadsplats anlitar en kund en person. På en arbetsleveransplattform anger kunden ett resultat, och systemet avgör vilken kombination av människor och maskiner som ska producera det.
Andrew Rabinovich, som leder AI-arbetet på Upwork, beskriver den enhet som köps som något mindre än ett jobb och mindre än en roll. Två årtionden av plattformsdata visar enligt honom, vilket han sade vid AI4, att den enorma variationen av arbete som publiceras på Upwork kan brytas ned till ungefär 500 till 1 000 återkommande uppgifter. Han kallar dem "atomära arbetsenheter", basfunktioner som kan kombineras på nytt till vilket uppdrag en kund än publicerar.

Ett företag som avser att sälja uppdelat arbete tar på sig en skyldighet. Det måste veta vilka uppdelade delar en maskin kan slutföra på egen hand, och det måste veta det med tillräcklig precision för att kunna satsa pengar på svaret.
Därför körde Upwork riktiga kundjobb genom ett riktmärke, publicerade resultaten som produktivitetsindex för människa + agent och dokumenterade metoden i en artikel som publicerades via arXiv i december.
Det viktigaste resultatet är vad agenterna slutförde. Det mer användbara resultatet är vad det kostar att få dem att slutföra det, och vem det visar sig att den kostnaden faller på.
Det arbete som lämpar sig bäst för automatisering
Metoden förtjänar mer uppmärksamhet än resultaten, eftersom den sätter gränsen för vad resultaten kan betyda.
Upwork hämtade 322 verkliga jobb som redan hade publicerats av betalande kunder och redan slutförts till kundens godkännande av mänskliga frilansare. Expertfrilansare skrev en bedömningsmall för varje jobb, med mellan 5 och 20 acceptanskriterier, indelade i kritiska, viktiga, valfria och fallgropar. Ett jobb räknades som slutfört endast om alla kritiska och viktiga kriterier var uppfyllda.
Tre modeller utförde arbetet: Claude, Gemini och GPT-5.
Det är vid urvalskriterierna som en chef bör stanna upp. Jobben begränsades till fastprisavtal med en enda milstolpe och tydligt definierad omfattning. Tidsåtgången sträckte sig från nio timmar till mer än 100 dagar, så det handlade inte enbart om mikrouppgifter. Öppet och komplext arbete uteslöts med motiveringen att agenterna inte hade någon rimlig chans att klara det.
Upwork beskriver den uteslutna kategorin som den stora majoriteten av det arbete som utförs på plattformen.
Ytterligare en begränsning är viktig för alla som är på väg att avfärda resultaten. Agenterna hölls medvetet grundläggande. Var och en läste jobbannonsen och eventuella bilagor, gjorde en plan, producerade en leverans och slutade sedan. Ingen webbsökning, ingen åtkomst till externa data, inga ytterligare verktyg och ingen träning på uppgiftstypen.
Som ett resultat påpekar författarna att resultaten inte är representativa för system med många verktyg och beskriver sina egna siffror som konservativa uppskattningar.
Varje siffra nedan uppmättes alltså på det mest lättillgängliga arbetet, där de svåra fallen hade tagits bort i förväg och med agenter som saknade de verktyg som de flesta företag faktiskt använder.
Administrativ support är svårare än den verkar
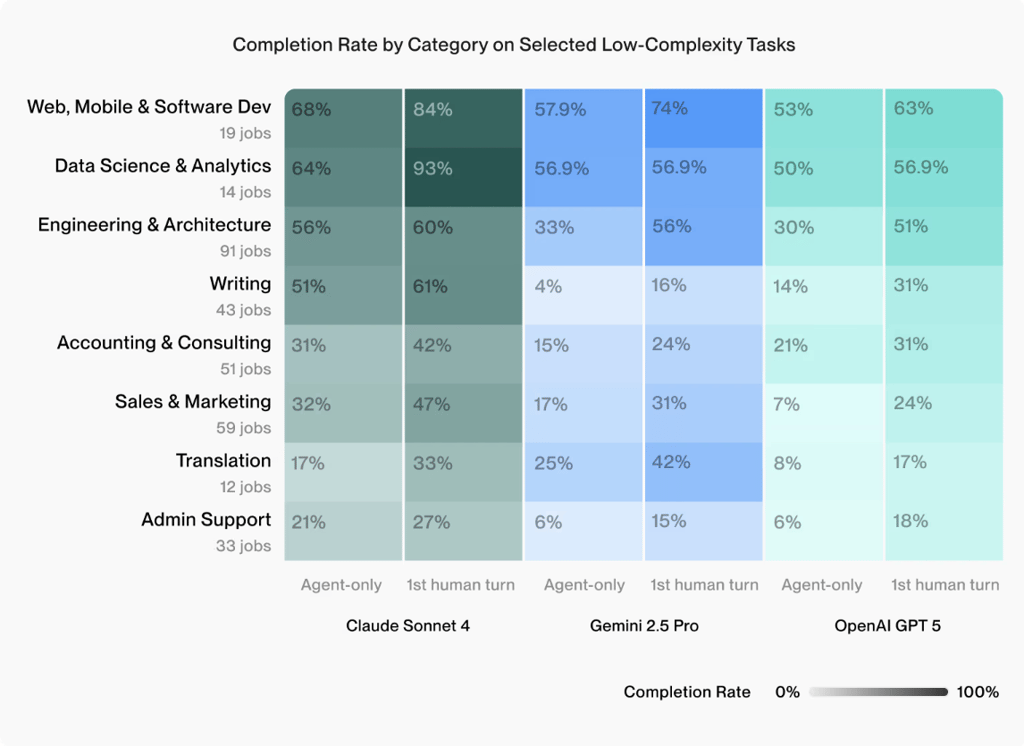
På egen hand uppfyllde agenterna alla kriterier för mellan 4 och 68 % av jobben, beroende på kategori och modell. Webbutveckling och programvaruutveckling låg i topp. Datavetenskap följde tätt efter.
Administrativ support hamnade i genomsnitt sist bland de tre modellerna och fick 6 % för två av dem.
Den ordningen går direkt emot hur de flesta automatiseringsplaner prioriteras. Administrativt arbete riktas först, utifrån det rimliga antagandet att det är det enklaste i hela byggnaden.
Riktmärket antyder att enkelt att beskriva och enkelt att verifiera är separata egenskaper, och att endast den andra förutsäger om en agent kan slutföra jobbet.
Rabinovichs egen beskrivning visar hur lätt det är att göra detta antagande. På frågan om effekten på frilansare beskrev han lågnivåarbete, som att bygga logotyper och skriva sammanfattningar av saker, som redan helt automatiserat bort. Hans företags riktmärke gav skrivande mellan 4 % och 51 % beroende på modell, där Gemini låg längst ned i det intervallet. Intuitionen och mätningen pekar i olika riktningar.
En omgång expertåterkoppling ökade den totala slutförandegraden för varje modell. Claude gick från 39,8 % till 51,2 % för uppgifter med låg komplexitet efter endast ett mänskligt ingripande. Gemini gick från 19,9 % till 32,3 %. GPT-5 gick från 19,6 % till 33,5 %. I absoluta tal innebär det en förbättring på 11 till 14 procentenheter genom en enda mänsklig insats.

Upwork marknadsför den övre delen av det relativa intervallet som en ökning på upp till 70 %, vilket är korrekt matematik baserat på GPT-5:s låga utgångsnivå och värt att läsa tillsammans med de absoluta siffrorna.
Förändringarna på kategorinivå var ojämna. Claudes resultat inom datavetenskap gick från 64 % till 93 %. Geminis resultat inom skrivande gick från 4 % till 16 %. Geminis resultat inom datavetenskap förändrades inte alls.
Inget nådde 100 %. Inte ens inom det enklaste tillgängliga arbetet, med en expert som vägledde det.
Verifiering är den del vi inte har löst
Rabinovich uppskattar den kvalitativa andelen av arbetet på plattformen till över 90 %, och han är tydlig med vad det innebär för utvärderingen. Deterministiskt arbete har sin egen kontroll. En översättning kan verifieras av en annan modell. Kod kompilerar och klarar antingen testerna eller gör det inte. För allt annat är den enda tillgängliga verifieringen en person med gott omdöme som granskar resultatet och avgör om det är bra eller inte.
Han beskrev detta som till stor del olöst och gick ännu längre.
Lös tillförlitlig validering av kvalitativa resultat, så har du mer eller mindre löst AI.
Författarna till rapporten är noggranna med vad deras egna siffror faktiskt bevisar i detta avseende. De genomförde inte matchade andra försök med enbart agenter på de jobb som misslyckades, vilket innebär att förbättringen inte kan särskiljas från effekten av att helt enkelt låta modellen försöka igen. Det är deras upplysning, som anges bland begränsningarna.
Vad benchmarktestet visar är snävare än vad Upworks formulering antyder. Ett andra försök efter expertfeedback överträffar ett första försök. Hur mycket av detta som beror på feedbacken och hur mycket som beror på det nya försöket har inte mätts.
Taknivån är det bestående resultatet. Under förhållanden som valts ut för att gynna agenternas framgång räddades ungefär ett av fem jobb som ursprungligen misslyckats genom ett andra, människostyrt försök, och slutförandegraden nådde som högst 51 % för den starkaste modellen. De människostyrda körningarna tog också ungefär fyra gånger längre tid: 14,5 minuter jämfört med 3,6.
Upworks eget produktbeslut pekar i samma riktning. UMA, företagets främsta AI-system, byggdes som en orkestreringsagent snarare än som en arbetare. Den tolkar avsikten, delar upp den, dirigerar delar till människor eller maskiner och kontrollerar resultatet. Den utför inte uppgiften.
Ett företag med alla kommersiella incitament att sälja autonom leverans utformade sitt centrala system utifrån antagandet att en människa förblir delaktig i arbetet.
Två frågor innan du finansierar ett arbetsflöde
Det finns två viktiga frågor att ställa om vad du vill att agenter ska göra.
Kan resultatet kontrolleras mot något objektivt? En testsvit, en avstämning, en efterlevnadsregel eller ett tal som antingen stämmer eller inte.
Håller sig arbetet inom en funktion och ett format? Eller går det från serverdel till klientdel, till text och till varumärkesgodkännande innan någon kan kalla det klart?
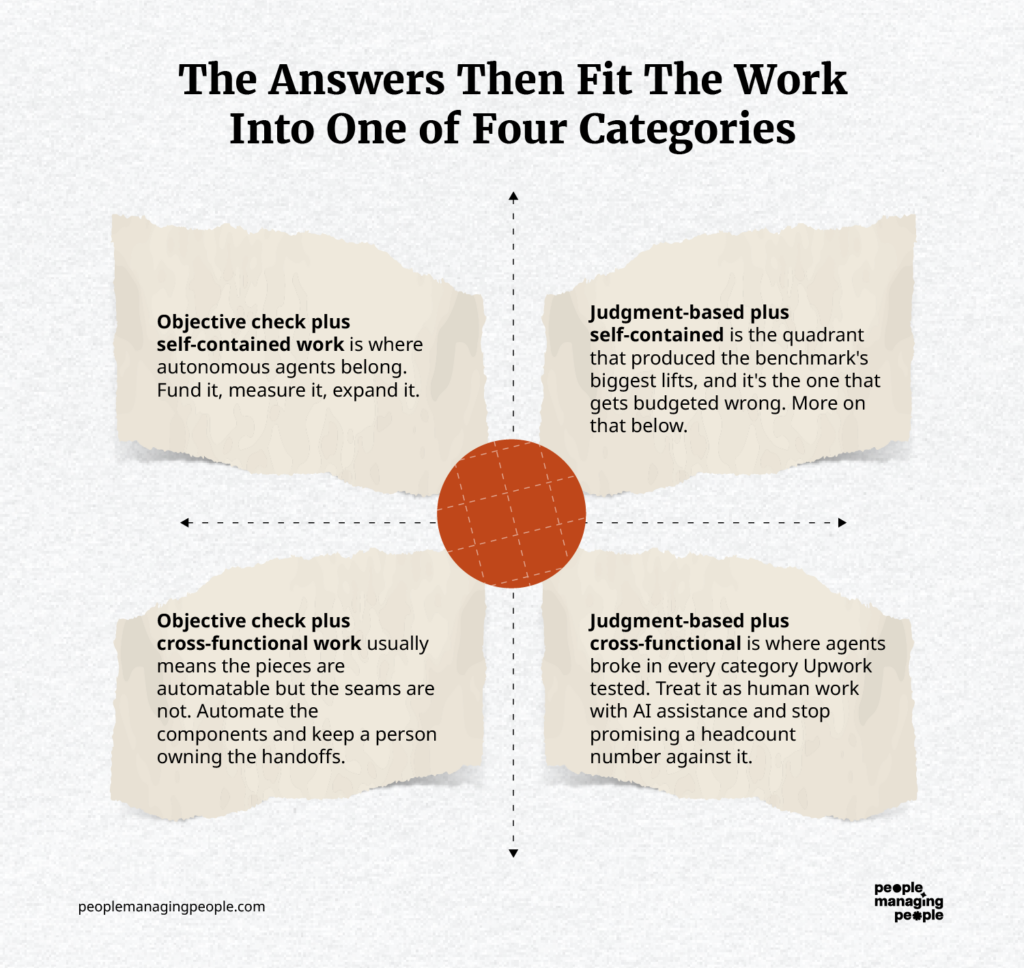
Objektiv kontroll plus självständigt arbete är där autonoma agenter hör hemma. Finansiera det, mät det och skala upp det.
Objektiv kontroll plus tvärfunktionellt arbete innebär vanligtvis att delarna kan automatiseras, men inte övergångarna mellan dem. Automatisera komponenterna och låt en person ansvara för överlämningarna.
Omdömesbaserat plus självständigt är den kvadrant som gav benchmarktestets största lyft, och det är den som får fel budget. Mer om det nedan.
Omdömesbaserat plus tvärfunktionellt är där agenter bröt samman i varje kategori som Upwork testade. Behandla det som mänskligt arbete med AI-stöd och sluta lova ett visst antal tjänster kopplat till det.
Upworks egen ekonomiska modellering hamnar ungefär på samma plats. Enbart agenter vinner på uppgifter med lågt värde där kostnaden för misslyckanden är liten, samarbete vinner i mitten och helt mänskligt utförande vinner i arbete med högt värde där ett dåligt resultat kostar mer än automatiseringen sparar.
Jobbet som Upwork valde att visa
HAPI-sidan innehåller fem exempeljobb med leveranser som du kan ladda ner. Ett av dem är en uppgift inom leadgenerering. Filtrera ett kalkylblad med mobilappar så att endast de som har sitt huvudkontor i USA återstår, hitta två till fyra marknadsföringskontakter för varje app och fyll i nio namngivna kolumner.
Objektivt kontrollerbart. En enda funktion, ett enda format. Bedömningskriterierna är synliga på sidan och inget av dem kräver någon smakbedömning.
Båda leveranserna fick underkänt i utvärderingen. Agenten som arbetade ensam misslyckades. Det gjorde även agenten som arbetade med en expert som vägledde den.
Upwork publicerade detta på sin egen marknadsföringssida, bredvid ett påstående om att samarbete kan öka slutförandegraden med upp till 70 %. Ge företaget erkännande för öppenheten och ta sedan till dig lärdomen, eftersom det jobbet ligger nära det arbete som företag redan överlåter åt en agent.
Rätt person i loopen?
Alla leverantörers presentationer säljer in människan i loopen som en säkerhetsfunktion. Läs utvärderingskriterierna och en annan fråga träder fram.
Alla Upworks granskare hade 100 % poäng för lyckade uppdrag och statusen Topprankad eller Topprankad Plus. Tillsammans hade de tjänat över 1 miljon dollar på plattformen under mer än 96 000 timmar.
Det är toppen av en global talangmarknad. Det är också den enda grupp granskare som testades. I rapporten står det att teamet inte kartlade utvärderarnas expertis eller undersökte hur en granskares bakgrund förändrar värdet av deras återkoppling. Det fanns inget villkor med juniora granskare.
Varje siffra i studien beskriver alltså ett bästa möjliga scenario för mänsklig övervakning, medan effekten av att bemanna den rollen med den som råkade ha kapacitet inte har mätts av någon.
Det är mitt argument snarare än riktmärkets, och det får två konsekvenser som de flesta arbetskraftsplaner inte har räknat med.
Den första är att granskning är produktionskapacitet, inte overhead. I kvadranten som kräver omdöme är experten inte en kontrollpunkt som bultats fast i en automatiserad process. Experten är den insats som förvandlar ett utkast till något som kan skickas vidare, och den fyrfaldiga tidsskillnaden mellan de två villkoren är kostnaden för den insatsen.
Om du klassificerar det som övervakning underskattar du arbetsflödet samtidigt som du överskattar besparingarna. Den kalkyl som motiverade investeringen slutar beskriva den process du faktiskt byggde.
Den andra konsekvensen är långsammare och värre. Varje plan som skär ned på roller på mellannivå för att finansiera AI-utgifter minskar också den grupp som om tre år blir tillräckligt senior för att åsidosätta en modell.
Expertomdöme är inte en merit, det är en restprodukt. Det byggs upp genom att utföra arbetet, dåligt till en början, medan någon mer erfaren korrigerar dig. Automatisera de första stegen i karriären och du behåller dagens granskare samtidigt som du tar bort mekanismen som skapar morgondagens.
Det är ett ledarskapsproblem innan det är ett bemanningsproblem, och det tillhör den som undertecknar beslutsunderlaget för automatiseringen.
Om agenter blir köpare är omdömet produkten
Rabinovichs syn på vart den här marknaden är på väg är att agenter blir en källa till efterfrågan snarare än endast en källa till utbud. En modell som arbetar sig igenom en uppgift som den inte kan verifiera – en medicinsk fråga, en restaurangrekommendation eller något annat som bygger på smak – anlitar en människa i realtid för att kontrollera den. Människan levererar inte projektet, utan validerar helt enkelt resultatet.
Det är en plattformschef som beskriver sin egen verksamhets uppsida, och det bör vägas in som sådan.
Konsekvensen för arbetskraften kvarstår oavsett om mekanismen kommer i den formen. Om verifiering är människans bestående bidrag, definieras de värdefulla rollerna av omdöme om resultatets kvalitet snarare än av produktionsvolym.
De rollerna är i dag utspridda över senioritetsnivåer, yrkesfamiljer och kostnadsställen som ofta inte kartläggs, vilket innebär att de flesta organisationer inte kan säga vilka personerna är eller vad det skulle kosta att ersätta dem.
Fyra åtgärder
Så vad kan du göra för att bedöma om du är redo att börja överlåta saker åt agenter för att slutföra åtminstone en del av arbetet?
- Hämta tio resultat från ditt mest automatiserade arbetsflöde och lägg dem framför den som tidigare ansvarade för arbetet. Fråga hur många de skulle ha skickat till en kund utan ändringar. Det talet är din verkliga automatiseringsgrad.
- Utse för varje automatiserat arbetsflöde den person som har befogenhet att avvisa resultatet. Kontrollera sedan om personen kan utöva den befogenheten utan att eskalera frågan.
- Omklassificera granskningstiden i arbetsflöden som hamnar i omdömeskvadranten. Flytta den från övervakning till produktion och gör om kalkylen.
- Läs era leverantörsavtal för att se vad slutförande innebär. Godkännande som poängsätts mot varje kriterium och ”uppgiften försöktes” är olika påståenden, och endast ett av dem är det som riktmärket mätte.

