

Når HR-ledere blir byggere

Lærdom fra eksperimentet: Samarbeidsprosjekter med AI ga dyp innsikt i HRs muligheter utover selve utviklingen av verktøyet.
Problemfokus: Overgangen fra sentimentanalyse til ferdighetskartlegging fremhevet hvor viktig det er å definere tydelige og oppnåelige mål.
Skepsis til AI: HR-fagfolk møter betydelige utfordringer knyttet til ansvarlighet og åpenhet i eksisterende AI-plattformer.
Verktøyets struktur: AI-vurderingsverktøyet la vekt på samarbeid og gjorde det mulig for brukerne å bekrefte eller utfordre AI-genererte tilbakemeldinger.
Konfronterende testing: Vellykket utvikling av verktøy krever grundig testing med varierte inndata for å håndtere grensetilfeller på en effektiv måte.
Møtene var satt opp til én time. De varte nesten alltid lenger.
Det er ikke uvanlig når man samler en gruppe HR-fagfolk for å snakke om AI. Det uvanlige var hva de ble bedt om å gjøre med denne samtalen. Ikke analysere den, ikke publisere en artikkel om den, men faktisk bygge noe.
Høsten 2025 satte jeg sammen det jeg kalte byggekohorter: en liten gruppe HR- og personaldriftsfagfolk som jeg hadde identifisert som allerede gjorde jobben, og som allerede tenkte på yttergrensene av hva HR-faget kunne gjøre med AI.

Hypotesen var enkel. De som står nærmest problemene, er best posisjonert til å bygge løsningene. Spørsmålet var om de kunne gjøre det.
Til sammen skulle jeg bygge fire kohorter, og underveis innse at det er lettere sagt enn gjort å definere mål for disse samlingene. Til slutt rant de fleste kohortene ut i sanden, fordi de slet med å realisere den opprinnelige visjonen eller bli enige om ett enkelt mål. Kalendere, arbeidsmengde og kravene fra de faktiske jobbene våre førte ofte til samtaler som ga gode ideer, men som aldri førte til at ideene ble realisert.
Men én kohort fant sammen og gikk faktisk så langt de kunne. Sannheten er at jo dypere man går ned i kaninhullet med å bygge det selv, desto vanskeligere blir det å ivareta en felles visjon og møte den tekniske utfordringen.
Denne historien er en beretning om det som kom ut av disse samlingene, og jeg gir den til deg som en casestudie i hvordan du kan bygge dine egne løsninger.
Kohorten


Dette var ikke AI-skeptikere som trengte å bli overbevist. De var praktikere som allerede hadde satset på dette øyeblikket. Det kohorten ga dem, var et strukturert rom der de kunne slutte å gi råd og begynne å skape.
Den første ærlige samtalen
Den første samlingen avdekket noe som sjelden kommer med i publiserte HR-kommentarer: hvor frustrerte disse fagfolkene faktisk er over verktøyene de forventes å bruke.
Turnmeyer satte tonen. Hun hadde forsøkt å få teknisk dokumentasjon om hvordan sentimentanalyse fungerte i BambooHR, Paycom og Gusto – ikke for å avfeie verktøyene, men fordi juristteamet hennes trengte å forstå dem før de godkjente bruken av dem.
Verken salgsteamene eller de juridiske representantene kunne svare på spørsmålene hennes. AI-funksjonene fantes. Ansvaret for hvordan de fungerte gjorde det ikke.
Gillies håndterte en parallell spenning. Interne stemmer hadde uttrykt bekymring for AIs miljøpåvirkning, og noen kolleger ønsket ganske enkelt å forby ansattes bruk av AI. Gillies motsatte seg dette.
Å forby AI fullstendig fører til skjult bruk og økt risiko. Det er bedre å ta i bruk AI med sikkerhetsrammer.
Melina Gillies · Personaldirektør, Flex Networks
Det som kom frem i løpet av den første timen, var en diagnose gruppen kunne enes om. De innebygde AI-funksjonene i HR-plattformer for virksomheter var, som Gillies uttrykte det, «ofte grunnleggende og mangler funksjonalitet.»
Verktøyene som faktisk fungerer, har en tendens til å være skreddersydde – utviklet for spesifikke problemer, spesifikke kontekster og spesifikke selskaper. Turnmeyer ønsket færre verktøy, ikke flere – et refreng jeg ofte hører fra ledere innen personal og drift. Hun kunne se for seg en fremtid der en kapabel AI, matet med de riktige dokumentene, gjorde et HRIS unødvendig.
De konfronterte også noe som sjelden blir tatt opp så direkte: etikken rundt atferdssporing. Ideen om å bruke andelen avviste møter, perioder uten systempålogging eller uvanlige arbeidstider som indikatorer på manglende engasjement, kom opp tidlig.
Det samme gjorde begrensningene ved denne tilnærmingen. Satterfield trakk frem en risiko som alle verktøy for måling av engasjement før eller siden møter: handlingslammelsesutmattelse. Hvis du samler inn data uten å handle synlig på dem, slutter de ansatte å stole på systemet. Dataene blir støy, og verktøyet blir AI-teater.
De var ikke klare til å bygge et verktøy for sentimentanalyse. Det var for bredt, for fullt av etiske dilemmaer og for lett å gjøre katastrofalt feil. Derfor la de om kursen.
Å finne det riktige problemet
Den andre økten begynte med en ærlig innrømmelse av at den opprinnelige retningen var for ambisiøs og for uklar.
«Jeg vet ikke om det måler engasjement», sa Turnmeyer, «eller om det bare måler noe som krever en samtale.»
Dette skillet er viktigere enn det kanskje høres ut som. Mye HR-teknologi gjør feilen å behandle data som en erstatning for samtaler. Gruppen prøvde å bruke AI til å avdekke øyeblikkene når en samtale må finne sted, og deretter gjøre denne samtalen bedre.
Satterfield introduserte ideen som skulle danne grunnlaget for resten av prosjektet. Under en ansettelsesstopp hos en tidligere arbeidsgiver hadde hun laget en egenvurdering av ferdigheter for teamet sitt innen talentanskaffelse – en måte å kartlegge hva folk kunne gjøre opp mot hva de faktisk ønsket å gjøre, og som genererte et varmekart som gjorde beslutninger om omplassering mer humane og mer strategiske.
Det var ikke AI-drevet. Det var et Microsoft-skjema. Men den underliggende logikken var god, bruksområdet var reelt, og hun hadde sett at det fungerte.
«Store leverandører prøver å gjøre dette, men ingen gjør det egentlig godt ennå, og mange selskaper har ikke satt av budsjett til denne typen teknologi i tillegg til sitt sentrale HRIS», sa hun.
Gruppen så muligheten. Hva om de bygde en AI-basert versjon? En som var samtalebasert i stedet for klinisk, fremtidsrettet i stedet for samsvarsdrevet, og priset for individuelle HR-ledere i stedet for å være låst bak virksomhetsavtaler?
Måten HR snakker med HR om HR på, er fundamentalt annerledes. Det kan ha en reell verdi, og de fleste verktøy overser det fullstendig.
Melina Gillies · Personaldirektør, Flex Networks
Fisher lyttet mens gruppen arbeidet seg gjennom mulighetene, og kom med en observasjon som ga prosjektets potensial en ny innramming. Han hadde opplevd begge ytterpunktene i HR-spekteret: den typen som setter samsvar og rammeverk først, og som er transaksjonell, og den sjeldnere, menneskefokuserte praktikeren som snakket til ham «som en person som følte at de var på min side.»
«Språket til den andre typen», sa han, «føltes aldri som om det kom fra et rammeverk skrevet for flere tiår siden. Det føltes bare bra.»
Gillies grep fatt i dette. Det som skulle skille verktøyet deres fra andre, hevdet hun, var tone og struktur. Hva om det kunne gjenskape måten HR-folk faktisk snakker med hverandre på en konferanse, mellom øktene og utenfor referat? Hva om det forsto «politisk teft» ikke som en avkrysningsboks, men som noe komplekst, omstridt og situasjonsavhengig som erfarne praktikere diskuterer seg imellom?
Det var retningen: et verktøy for vurdering før ansettelse, utviklet for HR- og talentanskaffelsesledere som trenger en bedre måte å evaluere kandidater til rekruttererstillinger på før de ansetter dem. Ikke en personlighetstest eller en gjennomgang av CV-en, men en strukturert, samtalebasert vurdering som kunne fortelle en ansettelsesleder om personen overfor dem faktisk visste hvordan jobben skulle gjøres. Et verktøy som føltes mindre som en prestasjonsevaluering og mer som en samtale med noen som forsto rekruttering fra innsiden.
Det avgjørende øyeblikket
Da den tredje økten begynte, var gruppen dypt inne i verktøyets arkitektur: hvilke kompetanser som skulle vurderes, hvordan de skulle struktureres på tvers av nivåer, og hvordan man skulle ta høyde for forskjellen mellom det folk sier at de kan gjøre, og det de faktisk kan.
Kritikken av eksisterende rammeverk kom fra Gillies, som beskrev SHRM-kompetansemodellen som «svært tradisjonell og på enkelte områder svært bakoverskuende.» Yrket var fortsatt, som hun uttrykte det, i en «postindustriell bakrus» – samsvarsbasert, hierarkisk og utformet for en verden som allerede var på vei tilbake.
Verktøyet deres måtte rettes mot noe annet – ikke det HR-ledere trengte å vite, men det de trengte å være i stand til å gjøre.
Er du villig til å ha en samtale med administrerende direktør om prestasjonene hans? Hvis du ikke er det, er du ikke ekspert på vanskelige samtaler.
Erin Turnmeyer · Leder for personaldrift
Turnmeyer hadde et klargjørende eksempel. Hun hadde nylig tatt SPHR-eksamen. Det hun måtte kunne – lover, prosedyredefinisjoner og klassifiseringsregler – var ting enhver kompetent HR-medarbeider ganske enkelt ville slå opp.
De harde ferdighetene var ikke sertifiseringsmaterialet. De var ting som: Kan du sitte overfor en administrerende direktør og fortelle ham noe han ikke ønsker å høre? Kan du tale en ansatts sak når forretningsgrunnlaget er uklart? Å pugge arbeidslivslovgivning gir ikke svar på disse spørsmålene.
Fisher gikk videre. Han hadde jobbet i årevis med endringsledelse, og hadde funnet ut at den mest prediktive variabelen for en organisasjons evne til å navigere i en omstilling ikke var noen bestemt ferdighet. Det var en persons forhold til tvetydighet.
Å finne ut hvor komfortable folk er med å være ukomfortable – eller med endringstempo generelt – er en så god indikator på evnen din til å fungere i denne nye verdenen.
Tim Fisher · Leder for KI, Black and White Zebra
Så kom det gruppen senere skulle kalle den hemmelige ingrediensen.
Gillies lanserte et spørsmål. Hva om verktøyet bygde inn en kontroll? Hvis noen vurderte seg selv som ekspert på konflikthåndtering, men deretter i et naturlig språksvar på en oppfølgende beskjed beskrev situasjoner som hørtes ut som alt annet enn ekspertise, kunne KI-en flagge det? Kunne den forsiktig si at det kanskje var et gap her?
«Det er øyeblikket da lyspæren tennes», sa Turnmeyer.
Satterfield bemerket at alle som har arbeidet med kompetanseoversikter, har sett varianter av det samme problemet. Folk vurderer ofte seg selv svært annerledes enn det deres faktiske erfaring eller atferd skulle tilsi.
Verdien i verktøyet ville ikke komme fra å registrere hva folk trodde om seg selv. Den ville komme fra kalibreringen – den forsiktige, datainformerte friksjonen mellom selvoppfatning og dokumentert mestring.
Vurderingen skulle ikke bare være et speil. Den skulle være mer «speil, speil på veggen» enn det de fleste er vant til fra arbeidsplassvurderinger.
Realitetene ved å bygge
Ingenting av dette var enkelt. Og gruppen visste det da de startet.
Den mest vedvarende utfordringen var ikke teknisk. Den var omfanget. Hver samling skapte ti nye retninger, alle genuint verdifulle, og alle i stand til å sluke hele prosjektet. Turnmeyer satte ord på det tidlig og gjorde det ofte.
«Sørg for at det gjør den første tingen riktig, så du ikke lar omfanget løpe så løpsk at du ikke klarer å lage det», sa hun.
Satterfield introduserte et veiledende prinsipp for gruppen: forskjellen mellom et minimum levedyktig produkt og et minimum verdifullt produkt. Et levedyktig produkt fungerer. Et verdifullt produkt får folk til å ville komme tilbake.
I et marked som er mettet av vurderingsverktøy, vil et grensesnitt som ikke leverer noe meningsfullt i den første interaksjonen, ikke få en ny sjanse til å forbedre seg. Kravet er ikke funksjonalitet. Det er verdi.
Hvis produktet ikke gir nok verdi ved første besøk, kommer brukerne sannsynligvis ikke tilbake senere for å se om det har blitt bedre.
Kelly Satterfield · HR-leder og konsulent
Det fantes også praktiske begrensninger som alle som har forsøkt å bygge noe utenfor et utviklingsteam, kjenner godt: utrulling, betalingsinfrastruktur, integrasjon med eksisterende systemer, kontekstvinduer som lukkes midt i en økt og sletter timevis med produktivt arbeid.
Den tidlige versjonen gjenspeilte verktøyets kjerneflyt. En kandidat til en rekrutteringsstilling laster opp en CV, verktøyet utleder en foreløpig kompetanseprofil, og leder deretter kandidaten gjennom en rekke samtalebaserte spørsmål som er utformet for å kalibrere og tilføre kontekst og dybde til den første vurderingen.
Til slutt får en ansettelsesansvarlig et bilde av hvor kandidaten faktisk står opp mot et definert kompetanserammeverk.
Fisher satte opp det primære utviklingsmiljøet i Lovable – en KI-bygger uten koding som genererer verktøy rettet mot offentligheten gjennom samtale, uten å låse brukerne til en bestemt LLM – slik at den tekniske arkitekturen kunne holde tritt med gruppens tanker uten å bli en flaskehals i seg selv.
Fra tegning til bygging
Ved den fjerde samlingen utformet gruppen ikke lenger et abstrakt verktøy. De bygde et, og oppdaget, slik utviklere alltid gjør, at avstanden mellom ideen og gjennomføringen er nettopp der den virkelige læringen finner sted.
Fisher hadde satt sammen en grunnleggende tilpasset GPT før samtalen startet, med instruksjoner, et foreløpig kompetanserammeverk og begynnelsen på samtalelogikken de hadde kartlagt i tidligere økter. Planen var at alle skulle få tilgang til den, gi den instrukser i fellesskap og begynne å kalibrere stemmen og atferden i sanntid. Planen møtte virkeligheten umiddelbart.
Den delte lenken fungerte ikke for noen andre enn meg. Arbeidsområdets tillatelser, plattformens særegenheter og måten ChatGPT håndterer ekstern tilgang på, slukte det første kvarteret av økten.
Det var en liten frustrasjon, nettopp den typen som aldri ville kommet med i en produktkunngjøring, og den var lærerik. Verktøy som fagfolk faktisk bruker til å bygge ting, oppfører seg ikke som demonstrasjoner.
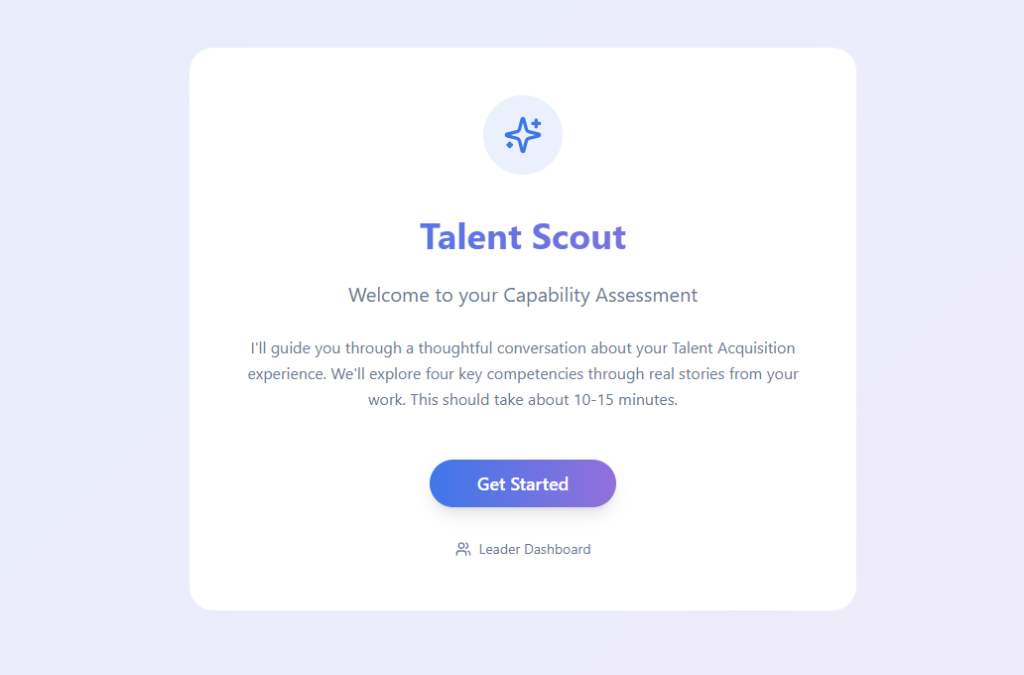
Dette skjermbildet viser hvordan velkomstskjermen etter hvert skulle se ut for verktøyet gruppen bygde, kalt Talent Scout.
Da alle så på den samme skjermen, skjedde det noe mer interessant. Mens gruppen fortsatt diskuterte hvilket format kompetansedefinisjonene skulle ha, åpnet Gillies Claude i et separat vindu og konverterte poengtabellen til strukturert JSON – direkte under samtalen.
«Jeg bruker Claude fordi det er bedre enn ChatGPT til dette», sa hun uten noe stort nummer ut av det. Hun la den formaterte filen inn i gruppechatten noen minutter senere. Ingen stoppet opp for å anerkjenne det. De gikk bare videre.
Denne typen problemløsning i farten – å gjøre en flaskehals til et løst problem uten å gjøre det til møtets hovedsak – er det som skiller fagfolk som virkelig har tilegnet seg disse verktøyene, fra dem som fortsatt lærer å navigere i dem.
Hvem får siste ord?
Satterfield stilte et spørsmål som ville få betydelige konsekvenser både for verktøyets arkitektur og for hvordan det etter hvert ville bli mottatt: Er det KI-en som fastsetter den endelige vurderingen, eller bekrefter brukeren den?
Forskjellen er ikke kosmetisk. Hvis verktøyet gir en konklusjon som «Basert på svarene dine er du på nivå 2 når det gjelder kandidatfokus», plasserer det KI-en i autoritetsrollen. Hvis det i stedet presenterer en foreløpig vurdering og inviterer brukeren til å si imot, endres dynamikken fullstendig. Vurderingen blir samarbeidende i stedet for evaluerende. Brukeren deltar i prosessen, i stedet for å være gjenstand for den.
«Godtar du denne tilbakemeldingen?» sa Turnmeyer da ideen tok form. «Jeg liker den veldig godt.»
Gillies bygde ut logikken. Hvis brukeren ikke godtar vurderingen, spør verktøyet hva som føles feil – og bruker deretter svaret til enten å kalibrere vurderingen på nytt eller forsiktig bekrefte den, samtidig som det går gjennom dokumentasjonen.
Denne samtalebaserte utvekslingen frem og tilbake er det som skaper den psykologiske tryggheten verktøyet trenger for å være genuint nyttig. Folk endrer seg ikke basert på tilbakemeldinger de ikke stoler på. Å få oppslutning er ikke en myk funksjon, det er selve mekanismen.
Den første virkelige testen
De bestemte seg for å teste prototypen direkte. Turnmeyer meldte seg frivillig til å gi et bevisst tynt svar på et av vurderingsspørsmålene – den typen svar en uengasjert kandidat eller distrahert medarbeider kunne ha gitt.
Hun beskrev en krangel med lederen sin om et avvik i lønnen, at hun mistet kandidaten, og at hun ikke hadde noen anelse om hva utfallet hadde blitt. Det var HR-motstykket til å svare «Jeg er bare veldig glad i mennesker» når man blir spurt om hvorfor man ønsker å jobbe med HR.
Verktøyet vurderte det umiddelbart. Det tildelte et nivå. Det var oppmuntrende. Det var også feil – ikke faktamessig, men for tidlig. Det hadde gjort antakelser om hva svaret innebar, i stedet for å be om den ekstra konteksten det trengte for å kunne vurdere nøyaktig.
Hvis du skal gi noen en annen vurdering enn «oppfyller forventningene», må du gi detaljerte eksempler. KI-en bør stille de samme kravene til seg selv.
Erin Turnmeyer · VP for personaldrift
Turnmeyer trakk parallellen direkte fra praksisen sin for medarbeidersamtaler. Hun hadde lenge krevd at ledere skulle legge frem konkrete bevis før de vurderte noen over eller under «oppfyller forventningene».
Den samme disiplinen bør gjelde for verktøyet. Før det tildeler et nivå, må det gjøre seg fortjent til å gjøre det ved å stille spørsmålene som gjør vurderingen forsvarlig. Igjen var det HR-ekspertisen i rommet som gjorde KI-en bedre – ikke omvendt.
Satterfield la til en komplikasjon verktøyet hadde oversett. Det tynne svaret kunne ha gjenspeilet retningslinjer snarere enn ferdigheter.
Hvis lederen faktisk hadde fastsatt et øvre tak for kompensasjonen, ville det ikke ha endret utfallet å argumentere hardere. Verktøyet hadde vurdert personen, når det egentlig burde ha spurt om situasjonen. Oppklarende spørsmål var ikke noe som bare skulle finpusses. De var det som ville skille en nyttig vurdering fra en overmodig vurdering.
Turnmeyer tok oppgaven med å skrive instruksjonene med seg som lekse: Hvordan ber man et verktøy stille oppklarende spørsmål på de riktige tidspunktene uten at enhver interaksjon føles som et avhør?
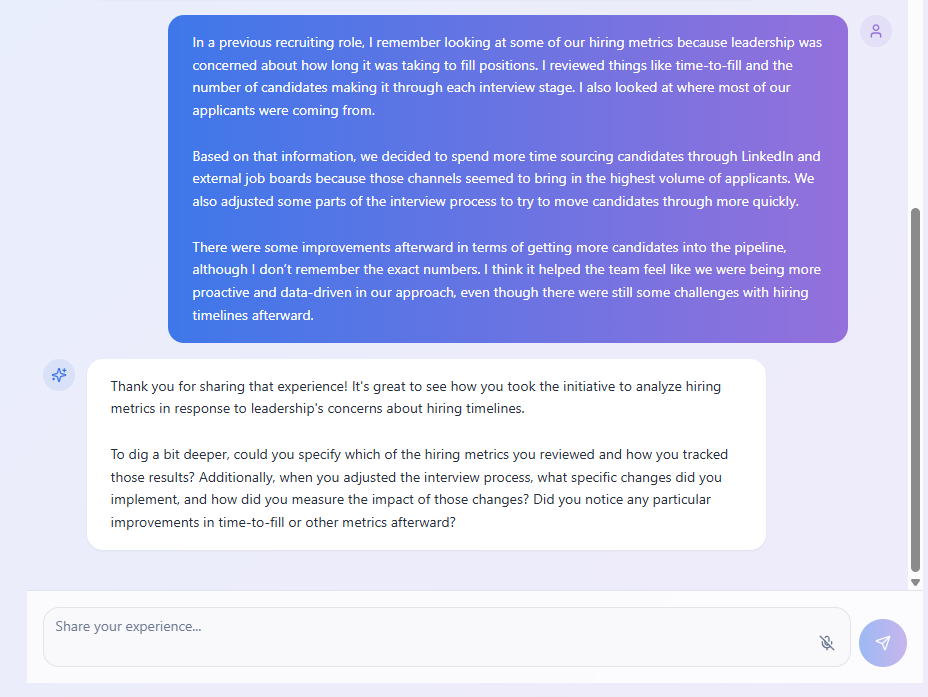
Dette skjermbildet viser et eksempel på hva sluttproduktet ville gjort: stilt oppklarende spørsmål og fått kandidaten til å gå mer i dybden.
Det er et vanskeligere problem enn det høres ut som, og hun var svært bevisst på at listen var uvanlig høy.
«Det må være bedre enn et menneske», sa hun. «Det er standarden.»
Testing som disiplin
Økten ga også et av de mer praktisk nyttige metodiske innspillene i hele gruppen. Da Satterfield spurte hvordan gruppen vanligvis testet verktøy som dette, svarte både Turnmeyer og Gillies på måter som avdekket noe viktig om hvordan grundig testing faktisk ser ut i praksis.
For verktøyet sitt for anbefalinger av personalgoder, som måtte finne nøyaktig ut om bestemte legemidler var dekket av selskapets helseforsikring, testet Turnmeyer spesifikt for yttertilfellene. Ikke de åpenbare legemidlene, de populære som modellen sannsynligvis hadde møtt gjentatte ganger i treningsdataene. Hun testet de obskure legemidlene, i kategoriene som mest sannsynlig ville føre til en selvsikker hallusinasjon.
«Jeg gikk og testet de upopulære legemidlene», sa hun, «fordi Claude viste meg hva den gjorde mens den bygget det.»
En slik bevisst, konfronterende tilnærming til testing er sjelden hos utviklere som kommer utenfra en teknisk kontekst. Det er også nettopp det som skiller verktøy som opparbeider seg tillit, fra verktøy som stille blir forlatt etter en pinlig feil.
Å kutte det du allerede har bygget
En samlingsøkt like før ferien startet med et spørsmål som var vanskeligere å stille enn det høres ut som: Hva er CV-opplastingsfunksjonen egentlig til for?
Gillies tok det opp. Vurderingen ba brukerne tenke nøye gjennom sine egne evner. Tilførte CV-en informasjon som brukeren ikke kunne gi mer direkte, bare ved å svare på spørsmålene? Ingen i gruppen var sikre på at den gjorde det. Den opprinnelige hensikten hadde vært å spare tid, slik en CV-parser gjør, men vi var ikke lenger overbevist om at den faktisk oppfylte dette.
De ble enige om å kutte den.
Dette er sjeldnere enn det høres ut som i produktutvikling. Gruppen hadde brukt betydelig tid på opplastingsfunksjonen – bygget den, testet den og sett på hvordan Satterfields CV ble tolket og feilbedømt. Å kutte den krevde at de overstyrte logikken rundt allerede investert tid, som får team til å fortsette å bygge videre på ting de allerede har investert i.
Begynn med slutten i tankene, og definer hvordan et godt resultat ser ut. Hvis du ikke kan forklare hva en funksjon er til for, kan du heller ikke forsvare den.
Turnmeyer kom med et beslektet argument om metodikk. I ettertid mente hun at de kanskje kunne ha beveget seg raskere ved å definere verktøyets atferd fullstendig før de skrev én eneste instruksjon. De hadde jobbet etter noe som lignet en smidig modell – bygge, teste, justere – mens kompleksiteten i det de bygget, kanskje krevde mer av en fossefallsmetode: få spesifikasjonen riktig først, og bygg deretter etter den.
Hun hadde et designdokument på 130 sider fra et annet verktøy hun hadde bygget, som hadde lært henne denne leksen. En fullstendig spesifikasjon forteller deg ikke bare hva du skal bygge. Den forteller deg også hva du ikke skal bygge, noe som viser seg å være like nyttig.
Gillies spisset produktets kjerneproblem. Uansett hva verktøyet viste på skjermen, måtte det gå lenger. En vurdering som avdekker data, er ikke det samme som et verktøy som forteller deg hva du skal gjøre med dem. Dette gapet mellom resultat og handling er der diagnostiske verktøy stille slutter å være nyttige, og det er et gap de fleste av dem aldri lukker.
Å bygge alene
Innen januar hadde Satterfield gjort det meste av byggingen selv, ettersom resten av gruppen opplevde at 9-til-5-jobbene deres krevde for mye tid til at det var noe igjen til prosjektet. Tross alt fikk ingen betalt for dette.
Hun hadde fjernet CV-opplastingen, slik gruppen hadde blitt enige om. Hun hadde lagt til taleinndata – brukerne kunne nå svare på vurderingsspørsmål ved å snakke i stedet for å skrive, noe som åpnet for en mer samtalepreget svarstil som var vanskeligere å manipulere enn et tekstfelt.
Hun hadde brukt ChatGPT til å generere syntetiske testsvar («Jeg er en juniorrekrutterer som er sterk på dette og svak på dette, gi meg svar»), for deretter å bytte til Lovable for å mate inn svarene og observere hvordan verktøyet vurderte dem.
Lederdashboardet var den andre halvdelen av verktøyets logikk – visningen en TA-direktør eller CHRO ville bruke for å se hvordan en kandidat hadde skåret, hvor hullene var, og hvordan kandidatens evner kunne utfylle styrkene og behovene til et eksisterende team.
Det gjorde organisasjonsstrukturen til et reelt problem, fordi verktøyet måtte vite hvem som vurderte hvem, og hvem som hadde myndighet til å se resultatene.
Satterfield hadde forsøkt å håndtere dette ved å be brukerne oppgi navn, stillingstittel og navnet på lederen sin (i mangel av en dataintegrasjon). Men denne logikken fungerte ikke i et vanlig scenario: en direktør for talentanskaffelse som ønsket å sende vurderingen ut i en bredere rekrutteringsorganisasjon som omfattet både direkte og indirekte rapporteringsforhold. Logikken for organisasjonskartlegging var ikke nyansert nok til å ta høyde for denne strukturen.
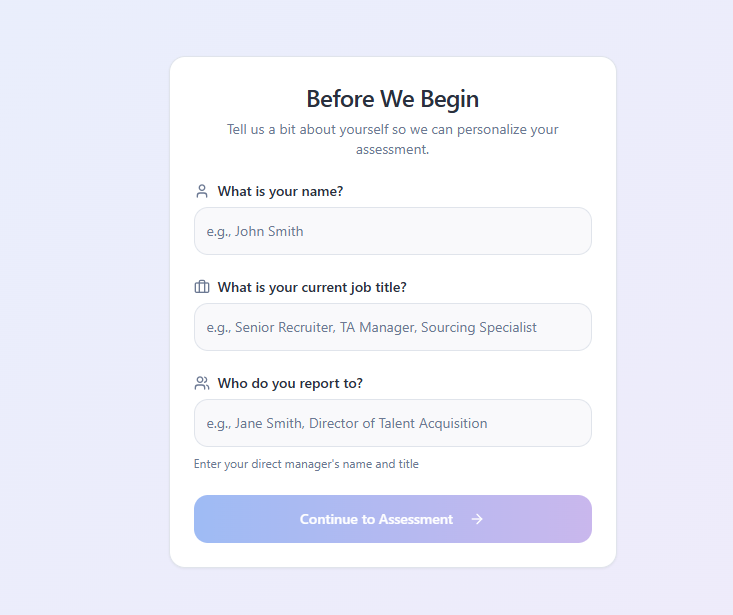
I teorien ville denne informasjonen gi verktøyet bedre kontekst om rollen til personen som gjennomførte vurderingen, men innsamling av mer data gjorde ting mer kompliserte.
Turnmeyer hadde allerede løst en versjon av dette problemet i en annen sammenheng. Verktøyet for prestasjonsledelse hun hadde utviklet for sitt eget selskap, kjørte på Google Sheets, Slack og Claude. Google Sheets lagret dataene. Slack var grensesnittet de ansatte samhandlet med. Claude håndterte analysen og genereringen av tilbakemeldinger.
Arkitekturen var enklere enn den hørtes ut: et regneark med navn, e-post, stillingsnivå og stillingstittel. En separat fane som koblet stillingsnivå til kompetanser.
«Sikkerhetsavdelingen i selskapet mitt ville gjennomgå verktøyet mitt», fortalte hun gruppen. «Jeg sa at det var lagret i Google Dokumenter. De sa: ‹Å, det er så enkelt.›»
Enkelt, men Turnmeyer lærte det først gjennom å bygge. Det hun ikke hadde visst tre uker tidligere, var at logging fantes – en funksjon som lagrer en brukers fremdrift, slik at verktøyet ikke tilbakestilles når noen går bort fra det og kommer tilbake.
«Jeg bannet til Claude», sa hun, «helt til den fortalte meg at logging fantes.»
Det er det bygging faktisk lærer deg. Ikke det du planla å lære, men det du ikke visste at du trengte å vite.
Spørsmålet under det hele
En gang i løpet av januarsamlingen kom samtalen frem til spørsmålet den hadde kretset rundt i flere måneder.
Gruppen fortsatte å diskutere arkitektur, tillatelser, lagring og dashbord – alle sammen reelle problemer. Men under dem lå et mer grunnleggende spørsmål. Hva var det egentlig de prøvde å bygge, og for hvem?
Verktøyet, slik det opprinnelig var tenkt, var et utvelgingsdiagnostisk verktøy – noe en TA-leder kunne sende til en kandidat eller intern medarbeider for å vurdere om de faktiske evnene deres samsvarte med det som sto på CV-en, og få frem dette bildet før en utvelgingsbeslutning ble tatt.
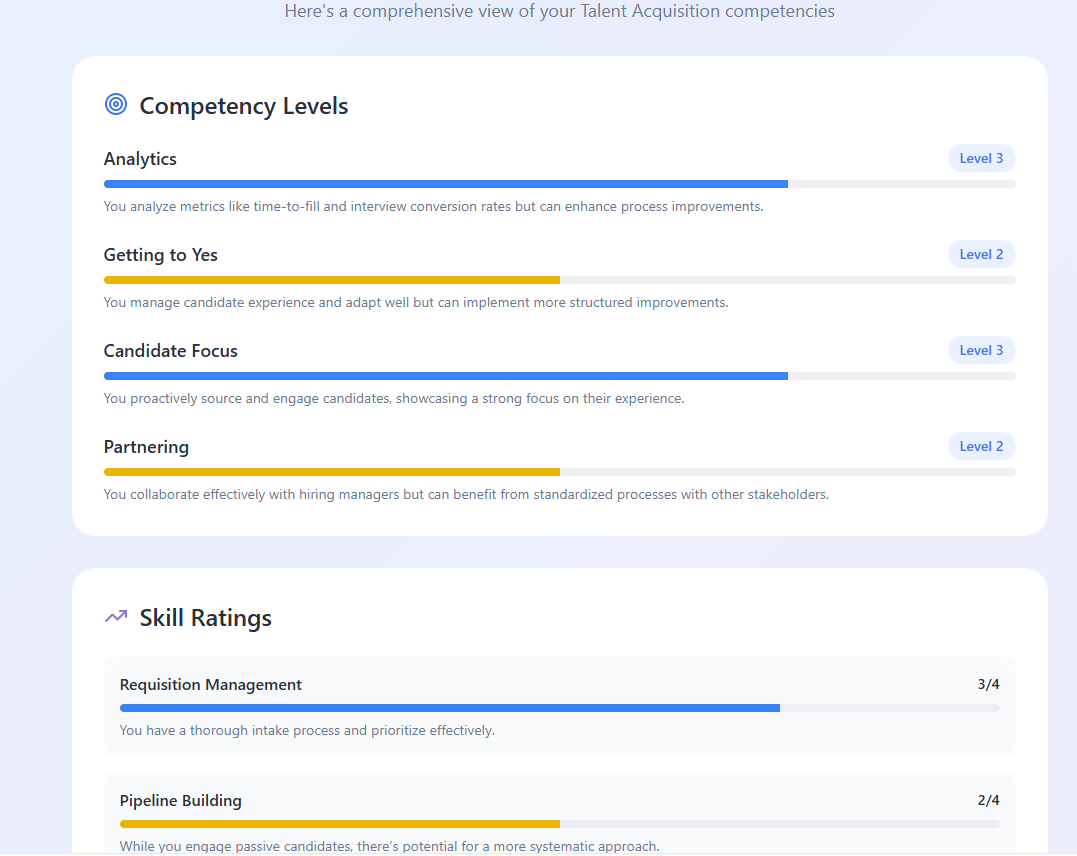


Det du ser her, er et utvalg skjermbilder av typen rapport verktøyet produserte for intervjuobjektet. For vurdereren hjelper et dashbord over det nåværende teamets styrker dem med å fokusere på hvor de bør vurdere intervjuobjektet, for å se om vedkommende kan dekke svakheter i TA-teamet.
Dette kjerneformålet hadde ikke endret seg. Men hver praktiske beslutning de hadde tatt – å legge til et lederdashbord, tenke gjennom abonnementsmodeller og finne ut hvordan innloggingsflyten skulle være – trakk dem mot noe mer komplekst.
Dashbord i sanntid innebar løpende tilgang, som innebar abonnementsavgifter, som igjen innebar at de nærmet seg den typen virksomhetsverktøy mange organisasjoner sliter med å ha råd til eller ta i bruk på en effektiv måte.
«Vi prøver ikke å bli en HCM-leverandør», sa Satterfield.
Turnmeyer var ærlig om hvor hun sto.
«Hensikten min var bare å lære noe nytt.»
Det var ikke en tilbaketrekning fra prosjektet. Det var en presis beskrivelse av hva eksperimentet allerede hadde gitt henne. Hun hadde lært noen nye ting og var allerede i gang med å bygge et nytt verktøy for prestasjonsledelse, basert på lærdommene fra gruppen.
Hun trengte ikke å gjøre gruppens verktøy til et produkt for å ha fått reell verdi ut av det.
På dette stadiet var min egen interesse først og fremst redaksjonell. Jeg ønsket en historie å fortelle og noe folk kunne se, ikke et abonnementsprodukt, men en demonstrasjon av at HR-ansvarlige kunne tenke gjennom og kanskje bygge noe lignende.
Det å skrive denne artikkelen var en del av det. Kunne jeg lage en nedlastbar veiledning? Etter hvert kanskje et direktesendt arrangement der gruppen kunne diskutere det de hadde gjort, la et publikum samhandle med verktøyet og ta opp samtalen som en podkast? Jeg hadde mange ideer, men tiden til å gjennomføre dem, etter hvert som målene for det nye året hopet seg opp foran oss alle, begynte å bli knappere.
Satterfields interesse var den mest kommersielt orienterte, og hun var tydelig på det. Hun var interessert i å gjøre det til et produkt etter hvert. Hun kom ikke til å gjøre det alene. Men hun var villig til å fortsette å bygge mot noe som en dag kunne selges.
Denne tredelte divergensen i hensikt – læring, historiefortelling, produkt – er sannsynligvis iboende i enhver gruppe som denne. Den ærlige samtalen om det i januar var mer nyttig enn å late som om alle alltid hadde ønsket det samme.
Demoen som svar
Spørsmålet om hvordan man skulle la folk prøve verktøyet, hadde stått uavklart siden opplastingen av CV-en ble lansert. Testing med reelle brukere er verdifullt, men skaper sine egne problemer. Verktøyet må fungere konsekvent, brukerne må ha nok kontekst til å vite hva de gjør, og en dårlig førstegangsopplevelse er vanskelig å rette opp.
Turnmeyer foreslo den enkleste løsningen gruppen hadde vurdert.
Hun hadde fulgt med på demoopptak – korte gjennomganger på ett eller to minutter som viste hvordan et verktøy fungerte, uten at seeren faktisk måtte bruke det. Hun foreslo at det kanskje var nok. Folk kunne se verktøyet i bruk, forstå hva det gjorde og hvorfor, og sitte igjen med følelsen av at det var mulig.
De ville ikke trenge å navigere gjennom en innlogging, oppgi et organisasjonskart eller stå fast når et spørsmål i vurderingen ikke passet til situasjonen deres.
Tilbakemeldingen jeg får fra mange av bloggene jeg skriver, er at folk egentlig ikke vil kopiere og lime inn nøyaktig det samme. De vil bare vite at de er i stand til å gjøre det.
Erin Turnmeyer · Visepresident for personaldrift
Denne observasjonen peker på noe reelt ved hvordan HR-medarbeidere forholder seg til KI-verktøy akkurat nå. Gapet mange av dem navigerer i, handler ikke om forskjellen mellom å vite at noe finnes og å bruke det. Det handler om å tro at de i det hele tatt er i stand til å gjøre noe slikt.
En demo som viser medarbeidere hvordan de bygger sitt eget verktøy, svarer på et annet spørsmål enn et ferdig produkt gjør – ikke «er dette verktøyet bra?», men «kunne noen som meg ha laget det?»
Ideen ble godt mottatt. Den imøtekom bekymringene rundt testing, reduserte kompleksiteten ved å dele noe som ikke var klart for produksjon, og beholdt fokuset der gruppen alltid hadde ment at det skulle være: på prosessen og tenkningen, ikke bare på resultatet.
Det eksperimentet lærte oss: En veiledning for HR-utviklere
- Start med problemet, ikke teknologien. Gruppens tidlige begeistring for sentimentanalyse var ekte, og den ledet dem bort fra et mer håndterbart og verdifullt problem. Skiftet til ferdighetskartlegging fungerte fordi det tok utgangspunkt i et reelt bruksområde som allerede var testet i praksis.
- Skreddersydd slår generisk. Alle deltakerne hadde møtt begrensningene i HR-plattformer for virksomheter. Verktøyene som ble bygget for spesifikke kontekster – Turnmeyers anbefalingsverktøy for frynsegoder og Satterfields varmekart – presterte bedre enn standardalternativene. Argumentet for å bygge sitt eget har aldri vært sterkere, og tersklene har aldri vært lavere.
- Kryssjekken er hele poenget. Selvvurderinger er bare så gode som folks kjennskap til seg selv, og den er notorisk upålitelig. Den virkelige verdien i et verktøy ligger i evnen til å undersøke, utfordre og forsiktig kalibrere på nytt – ikke bare registrere hva folk tror om seg selv.
- Minimum verdifullt, ikke minimum levedyktig. Hvis den første versjonen ikke leverer noe som får en bruker til å ville komme tilbake, spiller veikartet ingen rolle. Utform for førsteinntrykket, ikke det femte.
- Oppslutning er strukturell, ikke myk. Spørsmålet om KI-en utarbeider den endelige vurderingen, eller om brukeren bekrefter den, er ikke en detalj i brukeropplevelsen. Det avgjør om verktøyet er en autoritet eller en samarbeidspartner, og dette skillet former alt ved hvordan det blir mottatt og brukt.
- Fjern funksjoner dere allerede har bygget. Tankegangen om allerede påløpte kostnader får team til å fortsette å bygge ut ting de har investert i, lenge etter at disse tingene har sluttet å fortjene plassen sin. Hvis dere ikke kan forklare hva en funksjon skal brukes til, er det svaret deres. Å fjerne den er produktdisiplin, ikke fiasko.
- Test mot motstand, og tidlig. Finn personer som vil fortelle dere at verktøyet er dårlig. Gi det de verste rimelige inndataene dere kan forestille dere, og se hva det gjør. Bygg inn randtilfellene før dere finpusser de typiske. Verktøyets troverdighet avhenger av hvordan det håndterer øyeblikkene det ikke ble utformet for.
- Verktøyet bør gjøre seg fortjent til retten til å vurdere. Å gå rett til en vurdering før man har stilt nok spørsmål, er overmot, ikke effektivitet. Oppklarende spørsmål er det som gjør vurderingen forsvarlig, og det er forsvarligheten som gjør at tilbakemeldingen fester seg.
- Vær ærlig om hva alle er der for. Ulike hensikter innad i en gruppe er ikke et problem som må håndteres – de er informasjon. Å få dem på bordet tidlig sparer alle for å bygge mot et mål som bare noen av dem faktisk deler.
- De vanskeligste samtalene er de viktigste. Gruppen bygget et verktøy for å vurdere HR-ferdigheter, og i den prosessen hadde de en av de ærligste samtalene om HRs begrensninger som noen av dem kunne huske. Den samtalen – om bakoverskuende rammeverk, om gapet mellom eksamenskunnskap og situasjonsbestemt dømmekraft – var produktet i like stor grad som selve verktøyet.
Øktene som begynte som en forpliktelse til fire samtaler, strakte seg inn i vinteren og videre inn i det nye året. Prototypen var fortsatt under utvikling. Hensiktene til menneskene som hadde bygget den, hadde blitt tydeligere på måter som ikke lot seg løse på en ryddig måte.
Satterfield holdt fortsatt på å bygge. Turnmeyer hadde tatt det hun hadde lært, og anvendt det andre steder. Gillies hadde presset gruppen til å være mer disiplinert når det gjaldt hva verktøyet faktisk skulle gjøre. Jeg skrev historien om alt sammen.
Turnmeyer hadde sagt noe tidlig i prosessen som fortsatt viste seg å stemme: Hun bygde ikke fordi hun var blitt bedt om det, men fordi hun trengte å forstå.
Forståelsen av hva AI-verktøy faktisk gjør, hva de gjør feil, og hva som skal til for å gjøre dem nyttige, var ikke tilgjengelig i noe konferanseinnlegg eller noen leverandørdemonstrasjon. Den kom fra beslutningene gruppen tok, funksjonene de fjernet, øyeblikkene da verktøyet vurderte noen feil, og de måtte finne ut hvorfor.
Det mest nyttige deltakergruppen skapte, var ikke i prototypen. Det lå i tankearbeidet bak den.

