

Det agentene dine ikke kan fullføre uten deg

Kjerneendring: Upwork selger nå leveranse av arbeid, der systemer kombinerer mennesker og maskiner for å oppnå resultater fremfor å fylle roller.
Begrensninger ved referansemålingen: Upworks referansemåling av automatisering testet utvalgte jobber med lav kompleksitet, så resultatene kan ikke representere det meste av arbeidet på plattformen.
Menneskelig verdi: Menneskelige tilbakemeldinger forbedret agentenes gjennomføring, men krevde betydelig mer tid og ga aldri pålitelige resultater på tvers av alle jobbene.
Verifiseringsgap: Automatisering fungerer best når resultatene kan kontrolleres objektivt. Arbeid som i stor grad krever vurderinger og går på tvers av fagområder, trenger fortsatt et ansvarlig menneske som eier oppgaven.
Forretningsprøven: Mål automatisering ut fra godkjente resultater, pris ekspertgjennomgang som produksjon, og beskytt roller på mellomnivå som utvikler fremtidig dømmekraft.
Upwork har sluttet å kalle seg en talentmarkedsplass. Nå er betegnelsen «plattform for arbeidsleveranser», og endringen handler om mer enn posisjonering.
I en markedsplass ansetter en kunde en person. På en plattform for arbeidsleveranser beskriver kunden et resultat, og systemet avgjør hvilken kombinasjon av mennesker og maskiner som skal produsere det.
Andrew Rabinovich, som leder AI-arbeidet i Upwork, beskriver enheten som kjøpes, som noe mindre enn en jobb og mindre enn en rolle. To tiår med plattformdata tyder på, sa han under AI4, at det enorme mangfoldet av arbeid som legges ut på Upwork, kan brytes ned i omtrent 500 til 1 000 gjentakende oppgaver. Han kaller dem «atomiske arbeidsenheter», grunnfunksjoner som kan kombineres på nytt til ethvert oppdrag en kunde måtte legge ut.

Et selskap som har til hensikt å selge oppdelt arbeid, påtar seg en forpliktelse. Det må vite hvilke oppdelte deler en maskin kan fullføre på egen hånd, og det må vite dette med tilstrekkelig presisjon til å sette penger bak svaret.
Derfor kjørte Upwork reelle kundejobber gjennom en referansetest, publiserte resultatene som Human+Agent-produktivitetsindeksen og dokumenterte metoden i en artikkel publisert gjennom arXiv i desember.
Hovedfunnet er hva agentene fullførte. Det mer nyttige funnet er hva det koster å få dem til å fullføre det, og hvem denne kostnaden viser seg å tilfalle.
Arbeidet som egner seg best for automatisering
Metoden fortjener mer oppmerksomhet enn resultatene, fordi den setter grensen for hva resultatene kan bety.
Upwork hentet 322 reelle jobber som allerede var lagt ut av betalende kunder, og som allerede var fullført og godkjent av kundene etter arbeid utført av menneskelige frilansere. Ekspertfrilansere skrev en vurderingsmatrise for hver jobb, med mellom 5 og 20 akseptansekriterier, sortert i kritiske, viktige, valgfrie og fallgruver. En jobb ble regnet som fullført bare dersom alle kritiske og viktige kriterier var oppfylt.
Tre modeller utførte arbeidet: Claude, Gemini og GPT-5.
Det er i utvalgskriteriene en leder bør stoppe opp. Jobbene var begrenset til fastpriskontrakter med én milepæl og tydelig definert omfang. Varigheten varierte fra ni timer til mer enn 100 dager, så dette var ikke ensartede mikrouppgaver. Åpent og komplekst arbeid ble utelatt med den begrunnelse at agentene ikke hadde noen rimelig sjanse til å klare det.
Upwork beskriver denne utelatte kategorien som det aller meste av arbeidet som utføres på plattformen.
Én begrensning til er viktig for alle som er i ferd med å avvise resultatene. Agentene ble med vilje holdt på et grunnleggende nivå. Hver agent leste stillingsannonsen og eventuelle vedlegg, la en plan, produserte en leveranse og stoppet. Ingen nettsøk, ingen tilgang til eksterne data, ingen ekstra verktøy og ingen trening på oppgavetypen.
Forfatterne påpeker derfor at funnene ikke er representative for systemer med mange verktøy, og beskriver sine egne tall som konservative estimater.
Alle tallene nedenfor ble altså målt på det enkleste tilgjengelige arbeidet, med de vanskelige tilfellene fjernet på forhånd, ved hjelp av agenter som var fratatt verktøyene de fleste selskaper faktisk tar i bruk.
Administrativ støtte er vanskeligere enn det ser ut til
Alene oppfylte agentene alle kriteriene i mellom 4 og 68 % av jobbene, avhengig av kategori og modell. Nett- og programvareutvikling lå øverst. Datavitenskap fulgte like bak.
Administrativ støtte kom i gjennomsnitt sist på tvers av de tre modellene, med en skår på 6 % for to av dem.
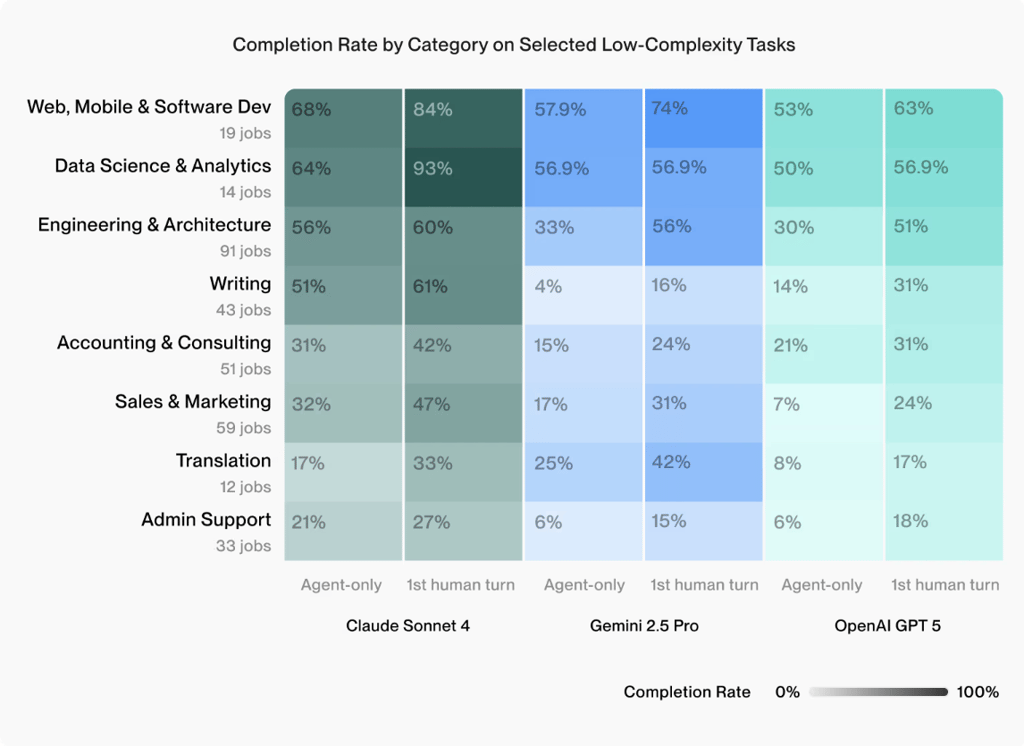
Denne rekkefølgen står i direkte motsetning til hvordan de fleste automatiseringsplaner blir lagt opp. Administrativt arbeid blir først utpekt, basert på den rimelige antakelsen at det er det enkleste i virksomheten.
Referansetesten antyder at det å være enkelt å beskrive og enkelt å kontrollere er separate egenskaper, og at bare den andre egenskapen forutsier om en agent kan fullføre jobben.
Rabinovichs egen fremstilling viser hvor lett det er å gjøre denne antakelsen. På spørsmål om virkningen for frilansere beskrev han arbeid på lavt nivå, som å lage logoer og skrive sammendrag av ting, som noe som allerede er fullstendig automatisert bort. Selskapets referansetest ga skrivearbeid en skår på mellom 4 % og 51 %, avhengig av modell, med Gemini nederst i dette intervallet. Intuisjonen og målingen peker i ulike retninger.
En runde med tilbakemeldinger fra eksperter økte den samlede fullføringsgraden for hver modell. Claude gikk fra 39,8 % til 51,2 % på oppgaver med lav kompleksitet etter bare én menneskelig inngripen. Gemini gikk fra 19,9 % til 32,3 %. GPT-5 gikk fra 19,6 % til 33,5 %. I absolutte tall er det en forbedring på 11 til 14 prosentpoeng etter én enkelt menneskelig involvering.

Upwork markedsfører toppen av det relative intervallet som en økning på opptil 70 %, noe som er korrekt aritmetikk basert på GPT-5s lave utgangspunkt og bør leses sammen med absoluttallene.
Utviklingen på kategorinivå var ujevn. Claudes gjennomføring innen datavitenskap gikk fra 64 % til 93 %. Geminis skriving gikk fra 4 % til 16 %. Geminis datavitenskap beveget seg ikke i det hele tatt.
Ingenting nådde 100 %. Ikke engang på det enkleste tilgjengelige arbeidet, med en ekspert som veiledet det.
Verifisering er delen vi ikke har løst
Rabinovich anslår den kvalitative andelen av arbeidet på plattformen til over 90 %, og han er tydelig på hva det betyr for evalueringen. Deterministisk arbeid har sin egen kontroll. En oversettelse kan verifiseres av en annen modell. Kode kompilerer og består tester, eller så gjør den ikke det. For alt annet er den eneste tilgjengelige verifiseringen en person med dømmekraft som ser på resultatet og avgjør om det er bra nok.
Han beskrev dette som i stor grad uløst, og gikk enda lenger.
Løs pålitelig validering av kvalitativt resultat, så har du mer eller mindre løst AI.
Forfatterne av artikkelen er nøye med hva deres egne tall faktisk viser på dette punktet. De gjennomførte ikke sammenlignbare, andre forsøk utført kun av agenten på jobbene som mislyktes, noe som betyr at forbedringen ikke kan skilles fra effekten av ganske enkelt å la modellen prøve på nytt. Dette opplyser de om under begrensningene sine.
Det referansen fastslår, er snevrere enn Upworks fremstilling antyder. Et andre forsøk etter ekspertveiledning gir bedre resultater enn et første forsøk. Hvor mye som skyldes veiledningen, og hvor mye som skyldes det nye forsøket, er ikke målt.
Taket er det varige funnet. Under forhold som var valgt ut for at agenten skulle lykkes, ble omtrent én av fem jobber som først mislyktes, reddet av et menneskestyrt andre forsøk, og gjennomføringen nådde maksimalt 51 % for den sterkeste modellen. De menneskestyrte forsøkene tok også omtrent fire ganger så lang tid, 14,5 minutter mot 3,6.
Upworks egen produktbeslutning peker i samme retning. UMA, selskapets fremste AI-system, ble bygget som en orkestreringsagent i stedet for en arbeider. Den tolker intensjonen, deler den opp, sender delene videre til mennesker eller maskiner og kontrollerer resultatet. Den utfører ikke oppgaven.
Et selskap med alle kommersielle insentiver til å selge autonom levering utformet sitt sentrale system rundt antakelsen om at et menneske fortsatt er involvert i arbeidet.
To spørsmål før du finansierer en arbeidsflyt
Det er to viktige spørsmål det er viktig å stille om hva du vil at agenter skal gjøre.
Kan resultatet kontrolleres mot noe objektivt? En testpakke, en avstemming, en samsvarsregel, et tall som enten samsvarer eller ikke gjør det.
Holder arbeidet seg innenfor én funksjon og ett format? Eller går det fra backend til frontend, videre til tekst og deretter til merkevaregodkjenning før noen kan kalle det ferdig?
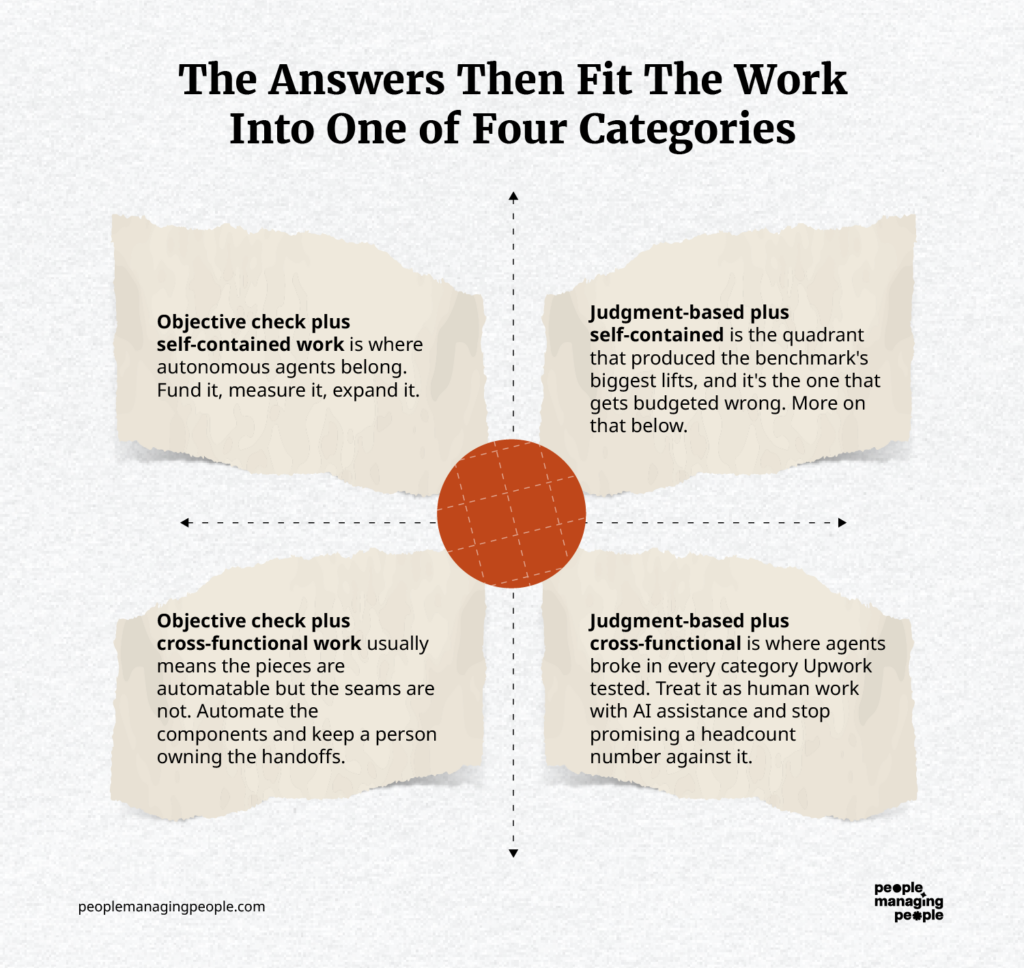
Objektiv kontroll pluss selvstendig arbeid er der autonome agenter hører hjemme. Finansier det, mål det og utvid det.
Objektiv kontroll pluss tverrfunksjonelt arbeid betyr vanligvis at delene kan automatiseres, men at overgangene ikke kan det. Automatiser komponentene og la en person ha ansvaret for overleveringene.
Skjønnsbasert pluss selvstendig arbeid er kvadranten som ga referansens største løft, og det er den som får feil budsjettildeling. Mer om det nedenfor.
Skjønnsbasert pluss tverrfunksjonelt arbeid er der agentene brøt sammen i hver kategori Upwork testet. Betrakt det som menneskearbeid med AI-støtte, og slutt å love et bestemt antall stillinger som skal erstattes av det.
Upworks egen økonomiske modellering havner omtrent på samme sted. Agenten alene vinner på oppgaver med lav verdi, der kostnaden ved feil er liten, samarbeid vinner i midten, og full menneskelig utførelse vinner på arbeid med høy verdi, der et dårlig resultat koster mer enn automatiseringen sparer.
Jobben Upwork valgte å vise frem
HAPI-siden inneholder fem eksempeljobber med leveranser du kan laste ned. Én av dem er en oppgave innen leadsgenerering. Filtrer et regneark med mobilapper ned til dem som har hovedkontor i USA, finn to til fire markedskontakter hos hver av dem, og fyll ut ni navngitte kolonner.
Objektivt etterprøvbart. Én funksjon, ett format. Kriteriene i vurderingsmatrisen er synlige på siden, og ingen av dem krever skjønn.
Begge leveransene ble vurdert som ikke godkjent. Agenten som jobbet alene mislyktes. Det samme gjorde agenten som jobbet med en ekspert som veiledet den.
Upwork publiserte dette på sin egen markedsføringsside, ved siden av en påstand om at samarbeid kan øke gjennomføringen med opptil 70 %. Gi selskapet honnør for åpenheten, og ta deretter lærdommen, fordi denne oppgaven er en nær parallell til arbeid selskaper allerede overlater til en agent.
Riktig person i sløyfen?
Alle leverandørpresentasjoner selger mennesket i sløyfen som en sikkerhetsfunksjon. Les vurderingskriteriene, så dukker det opp et annet spørsmål.
Alle Upworks vurderere hadde en Job Success Score på 100 %, med status som topprangert eller ekstra topprangert. Til sammen hadde de tjent over 1 million dollar på plattformen gjennom mer enn 96 000 timer.
Det er toppen av et globalt talentmarked. Det er også den eneste gruppen av vurderere som ble testet. I artikkelen står det at teamet ikke kartla vurderernes ekspertise eller undersøkte hvordan en vurderers bakgrunn påvirker verdien av tilbakemeldingene deres. Det fantes ingen betingelse med juniorer.
Dermed beskriver hvert eneste tall i studien et best mulig tilfelle for menneskelig kontroll, mens effekten av å bemanne rollen med den som tilfeldigvis hadde kapasitet, ikke er målt av noen.
Det er mitt argument, ikke referansegrunnlagets, og det får to konsekvenser som de fleste bemanningsplaner ikke har tatt høyde for.
Den første er at kontroll er produksjonskapasitet, ikke indirekte kostnader. I kvadranten for oppgaver som krever skjønn er eksperten ikke et kontrollpunkt som er koblet på en automatisert prosess. Eksperten er innsatsen som gjør et utkast leveringsklart, og den firedoble tidsforskjellen mellom de to betingelsene er kostnaden for denne innsatsen.
Hvis du klassifiserer det som kontroll, undervurderer du arbeidsflyten samtidig som du overvurderer besparelsene. Regnestykket som begrunnet investeringen, beskriver ikke lenger prosessen du faktisk har bygget.
Den andre konsekvensen er langsommere og verre. Alle planer som tynner ut roller på mellomnivå for å finansiere AI-utgifter, kutter også i gruppen som om tre år blir senior nok til å overstyre en modell.
Ekspertvurderinger er ikke en kvalifikasjon, men en rest. De akkumuleres gjennom å utføre arbeidet, først dårlig, mens en mer erfaren person korrigerer deg. Automatiser de første trinnene, så beholder du dagens vurderere, samtidig som du fjerner mekanismen som produserer morgendagens.
Det er et ledelsesproblem før det er et bemanningsproblem, og det tilhører den som signerer beslutningsgrunnlaget for automatiseringen.
Hvis agenter blir kjøpere, er skjønn produktet
Rabinovichs syn på hvor dette markedet går videre, er at agenter blir en kilde til etterspørsel snarere enn bare en kilde til tilbud. En modell som arbeider seg gjennom en oppgave den ikke kan verifisere, enten det gjelder et medisinsk spørsmål, en restaurantanbefaling eller noe annet som bygger på smak, leier inn et menneske i sanntid for å kontrollere den. Mennesket leverer ikke prosjektet, men validerer ganske enkelt resultatet.
Det er en plattformleder som beskriver oppsiden for sitt eget selskap, og det bør vurderes deretter.
Konsekvensen for arbeidsstyrken består uansett av om mekanismen oppstår i denne formen. Hvis verifisering er menneskets varige bidrag, defineres rollene som har verdi av vurderinger av kvaliteten på resultatet, ikke av produksjonsvolum.
Disse rollene er i dag spredt på tvers av senioritetsnivåer, stillingsfamilier og kostnadssteder som ofte ikke er kartlagt, noe som betyr at de fleste organisasjoner ikke kan si hvem de er, eller hva det vil koste å erstatte dem.
Fire grep
Så hva kan du gjøre for å vurdere om du er klar til å begynne å overlate ting til agenter, slik at de fullfører i det minste deler av arbeidet?
- Hent ut ti resultater fra den mest automatiserte arbeidsflyten din og legg dem frem for den som tidligere eide arbeidet. Spør hvor mange vedkommende ville ha sendt til en kunde uten endringer. Det tallet er den reelle automatiseringsgraden din.
- For hver automatiserte arbeidsflyt, angi personen som har myndighet til å avvise resultatet. Kontroller deretter om vedkommende kan utøve denne myndigheten uten å eskalere.
- Omklassifiser tiden som brukes på kontroll i arbeidsflyter som faller i skjønnskvadranten. Flytt den fra kontroll til produksjon, og kjør beslutningsgrunnlaget på nytt.
- Les leverandørkontraktene dine for å se hva gjennomføring betyr. Aksept vurdert mot hvert enkelt kriterium i vurderingsmatrisen og «oppgaven forsøkt» er to forskjellige påstander, og bare én av dem er det referansegrunnlaget målte.

