

När HR-ledare blir byggare
Insikt från experimentet: Samarbetsinriktade AI-projekt gav djupgående insikter i HR:s förmågor, långt bortom själva verktygsutvecklingen.
Fokus på problemet: Skiftet från sentimentanalys till kompetenskartläggning belyste vikten av att definiera tydliga och uppnåeliga mål.
Skepsis mot AI: HR-specialister möter betydande utmaningar när det gäller ansvar och transparens i befintliga AI-plattformar.
Verktygets struktur: Bedömningsverktyget med AI betonade samarbete genom att låta användarna bekräfta eller ifrågasätta AI-genererad återkoppling.
Motståndskraftig testning: Framgångsrik verktygsutveckling kräver rigorösa tester med varierade indata för att effektivt hantera gränsfall.
Mötena var schemalagda till en timme. De drog nästan alltid ut på tiden.
Det är inte ovanligt när man samlar en grupp HR-professionella för att prata om AI. Det ovanliga var vad de ombads göra med det samtalet. Inte analysera det, inte publicera en tankesmedja om det, utan faktiskt bygga något.
Hösten 2025 samlade jag det jag kallade byggarkohorter: en liten grupp HR- och personaloperationsprofessionella som jag hade identifierat som redan gjorde jobbet och redan tänkte kring gränserna för vad HR-yrket kunde göra med AI.

Hypotesen var enkel. De som står närmast problemen är bäst positionerade för att bygga lösningarna. Frågan var om de kunde göra det.
Totalt skulle jag bygga fyra kohorter, och på vägen inse att det är lättare sagt än gjort att definiera mål för dessa sessioner. I slutändan rann de flesta kohorterna ut i sanden, eftersom de hade svårt att förverkliga den ursprungliga visionen eller enas om ett enda mål. Kalendrar, arbetsbelastning och kraven från våra faktiska jobb ledde ofta till samtal som gav upphov till fantastiska idéer utan att de någonsin förverkligades.
Men en kohort samlades och tog sig faktiskt hela vägen så gott de kunde. Faktum är att ju längre ner i kaninhålet ”bygg det själv” man går, desto svårare blir det att hålla fast vid en gemensam vision och möta den tekniska utmaningen.
Den här berättelsen redogör för vad som kom ut av dessa sessioner och jag erbjuder den till dig som en fallstudie i att bygga egna lösningar.
Kohorten


Det här var inte AI-skeptiker som behövde övertygas. Det var yrkesverksamma som redan hade satsat på det här ögonblicket. Det kohorten erbjöd dem var ett strukturerat utrymme där de kunde sluta ge råd och börja skapa.
Det första ärliga samtalet
Den första sessionen blottlade något som sällan kommer med i publicerade HR-kommentarer: hur frustrerade dessa yrkesverksamma faktiskt är över de verktyg de förväntas använda.
Turnmeyer satte tonen. Hon hade försökt få teknisk dokumentation om hur sentimentanalys fungerade i BambooHR, Paycom och Gusto – inte för att avfärda verktygen, utan för att hennes juridiska team behövde förstå dem innan de godkände användningen av dem.
Varken säljteamet eller de juridiska representanterna kunde besvara hennes frågor. AI-funktionerna fanns. Ansvarsskyldigheten för hur de fungerade gjorde det inte.
Gillies hanterade en parallell spänning. Interna röster hade uttryckt oro över AI:s miljöpåverkan, och vissa kollegor ville helt enkelt förbjuda anställdas användning av AI. Gillies invände.
Att helt förbjuda AI leder till dold användning och ökad risk. Att använda AI med skyddsräcken är ett bättre tillvägagångssätt.
Melina Gillies · personalchef, Flex Networks
Det som framkom under den första timmen var en problembeskrivning som gruppen kunde enas om. De inbyggda AI-funktionerna i HR-plattformar för företag var, som Gillies uttryckte det, "ofta grundläggande och saknar funktionalitet."
De verktyg som faktiskt fungerar brukar vara skräddarsydda – byggda för specifika problem, specifika sammanhang och specifika företag. Turnmeyer ville ha färre verktyg, inte fler, en återkommande synpunkt som jag ofta hör från chefer inom personal och verksamhetsdrift. Hon kunde föreställa sig en framtid där en kapabel AI, försedd med rätt dokument, gjorde ett HRIS överflödigt.
De konfronterade också något som sällan tas upp så här direkt: etiken kring beteendespårning. Idén att använda andelen avböjda mötesinbjudningar, luckor i systeminloggningar eller ovanliga arbetstider som indikatorer på bristande engagemang kom upp tidigt.
Det gjorde även begränsningarna med den metoden. Satterfield nämnde en risk som alla verktyg för engagemang förr eller senare ställs inför: handlingsutmattning. Om man samlar in data utan att synligt agera på den slutar medarbetarna att lita på systemet. Data blir brus och verktyget blir AI-teater.
De var inte redo att bygga ett verktyg för känsloanalys. Det var för brett, alltför laddat med etiska dilemman och för lätt att få katastrofalt fel. Därför bytte de riktning.
Att hitta rätt problem
Den andra sessionen började med ett ärligt erkännande av att den ursprungliga inriktningen var för ambitiös och för oklar.
"Jag vet inte om det mäter engagemang", sade Turnmeyer, "eller om det bara mäter något som kräver ett samtal."
Den skillnaden spelar större roll än man kanske tror. Många HR-tekniklösningar gör misstaget att behandla data som ett substitut för samtal. Gruppen försökte använda AI för att synliggöra de ögonblick då ett samtal behöver äga rum och sedan göra det samtalet bättre.
Satterfield introducerade idén som skulle bli projektets grund. Under ett anställningsstopp hos en tidigare arbetsgivare hade hon byggt en självskattning av kompetenser för sitt team inom talanganskaffning – ett sätt att kartlägga vad människor kunde göra i förhållande till vad de faktiskt ville göra, vilket skapade en värmekarta som gjorde beslut om omplacering mer humana och mer strategiska.
Den var inte AI-driven. Det var ett Microsoft-formulär. Men den underliggande logiken var sund, användningsområdet var verkligt och hon hade sett att det fungerade.
"Stora leverantörer försöker göra det här, men ingen gör det riktigt bra ännu, och många företag har ingen budget avsatt för den här typen av teknik utöver sitt centrala HRIS", sade hon.
Gruppen såg möjligheten. Tänk om de byggde en AI-infödd version? En som var samtalsbaserad i stället för klinisk, framåtblickande i stället för regelefterlevnadsdriven och prissatt för enskilda HR-chefer i stället för låst bakom företagsavtal?
Sättet som HR pratar med HR om HR skiljer sig fundamentalt. Det kan vara ett verkligt värde, och de flesta verktyg missar det helt.
Melina Gillies · personalchef, Flex Networks
Fisher, som lyssnade medan gruppen arbetade sig igenom möjligheterna, kom med en iakttagelse som omformulerade projektets potential. Han hade upplevt båda ändarna av HR-spektrumet: den regelefterlevnadsorienterade, ramverksorienterade och transaktionella sorten samt den mer sällsynta, människoorienterade yrkesutövaren som pratade med honom "som en person som kändes som om hen stod på min sida."
"Språket hos den andra sorten", sade han, "kändes aldrig som om det kom från ett ramverk som skrivits för årtionden sedan. Det kändes helt enkelt bra."
Gillies tog fasta på det. Hon hävdade att verktygets särskiljande faktor var ton och struktur. Tänk om det kunde efterlikna sättet som HR-proffs faktiskt pratar med varandra på en konferens, mellan sessionerna, utan protokoll? Tänk om det förstod "politiskt fingertoppskänslig" inte som en kryssruta utan som något laddat, omstritt och situationsmässigt komplext som erfarna yrkesutövare diskuterar sinsemellan?
Det var inriktningen: ett bedömningsverktyg före anställning, utformat för HR- och talanganskaffningschefer som behöver ett bättre sätt att utvärdera kandidater till rekryterartjänster innan de anställs. Inte ett personlighetstest eller en granskning av CV:n, utan en strukturerad, samtalsbaserad diagnostik som kunde tala om för en rekryterande chef om personen framför dem faktiskt visste hur jobbet skulle utföras. Ett verktyg som kändes mindre som en prestationsutvärdering och mer som ett samtal med någon som förstod rekrytering inifrån.
Ögonblicket då allt föll på plats
Vid den tredje sessionen hade gruppen kommit djupt in i verktygets arkitektur: vilka kompetenser som skulle bedömas, hur de skulle struktureras på olika nivåer och hur man skulle hantera skillnaden mellan vad människor säger att de kan göra och vad de faktiskt kan.
Kritiken mot befintliga ramverk kom från Gillies, som beskrev SHRM:s kompetensmodell som "mycket traditionell och i vissa avseenden mycket bakåtblickande." Yrket befann sig fortfarande, med hennes formulering, i en "postindustriell baksmälla" – regelefterlevnadsbaserad, hierarkisk och utformad för en värld som redan höll på att försvinna.
Deras verktyg behövde inriktas på något annat, inte på vad HR-ledare behövde veta, utan på vad de behövde kunna göra.
Är du villig att ha ett samtal med vd:n om hans prestation? Om du inte är det är du inte expert på svåra samtal.
Erin Turnmeyer · VP för personalverksamhet
Turnmeyer hade ett klargörande exempel. Hon hade nyligen gjort SPHR-examen. Det hon behövde kunna – lagar, processuella definitioner och klassificeringsregler – var sådant som alla kompetenta HR-specialister helt enkelt skulle slå upp.
De hårda färdigheterna var inte certifieringsmaterialet. De handlade snarare om saker som: Kan du sitta mitt emot en vd och berätta något för honom som han inte vill höra? Kan du föra en anställds talan när affärsunderlaget är otydligt? Att memorera arbetsrättsliga koder besvarar inte de frågorna.
Fisher drev frågan vidare. Han hade arbetat i flera år med förändringsledning och hade kommit fram till att den mest förutsägande variabeln för en organisations förmåga att navigera i en omvandling inte var någon specifik färdighet. Det var en persons förhållande till tvetydighet.
Att ta reda på hur bekväm någon är med att vara obekväm – eller med förändringstakten i allmänhet – är en så tydlig indikator på din förmåga att fungera i den här nya världen.
Tim Fisher · Chef för AI, Black and White Zebra
Sedan kom det som gruppen senare skulle kalla den hemliga ingrediensen.
Gillies kastade fram en fråga. Tänk om verktyget byggde in en kontroll? Om någon bedömde sig själv som expert på konflikthantering, men sedan i ett svar på naturligt språk på en följdfråga beskrev situationer som lät som allt annat än expertis – skulle AI:n kunna flagga det? Skulle den varsamt kunna säga att det kanske finns ett glapp här?
"Det är ögonblicket då polletten trillar ner", sade Turnmeyer.
Satterfield påpekade att alla som har arbetat med kompetensinventeringar har sett varianter av samma problem. Människor bedömer ofta sig själva på ett helt annat sätt än vad deras faktiska erfarenhet eller beteende skulle antyda.
Värdet i verktyget skulle inte komma från att registrera vad människor trodde om sig själva. Det skulle komma från kalibreringen – den varsamma, datainformerade friktionen mellan självbild och visad förmåga.
Bedömningen skulle inte bara vara en spegel. Den skulle vara mer av typen ”spegel, spegel på väggen” än vad de flesta är vana vid från arbetsplatsbedömningar.
Verkligheten i att bygga
Inget av detta var enkelt. Och gruppen visste det redan från början.
Den mest ihållande utmaningen var inte teknisk. Den handlade om omfattningen. Varje session genererade tio nya riktningar, var och en genuint värdefull och var och en kapabel att sluka hela projektet. Turnmeyer satte ord på det tidigt och återkom ofta till det.
"Se till att den gör den första saken rätt, så att omfattningen inte smyger iväg så mycket att ni inte kan skapa den", sade hon.
Satterfield introducerade en vägledande princip för gruppen: skillnaden mellan en minimalt fungerande produkt och en minimalt värdefull produkt. En fungerande produkt fungerar. En värdefull produkt får människor att vilja återvända.
På en marknad som är mättad med bedömningsverktyg får ett gränssnitt som inte levererar något meningsfullt vid den första interaktionen ingen andra chans att förbättras. Ribban är inte funktionalitet. Det är värde.
Om produkten inte ger tillräckligt värde vid det första besöket kommer användarna sannolikt inte tillbaka senare för att se om den har blivit bättre.
Kelly Satterfield · HR-ledare och konsult
Det fanns också de praktiska begränsningar som alla som har försökt bygga något utanför ett utvecklingsteam känner väl till: driftsättning, betalningsinfrastruktur, integration med befintliga system, kontextfönster som stängs mitt under en session och raderar timmar av produktivt arbete.
Den tidiga versionen återspeglade verktygets centrala flöde. En kandidat till en rekryterarroll laddar upp ett CV, verktyget drar slutsatser om en preliminär kompetensprofil och leder sedan kandidaten genom en serie samtalsbaserade frågor som är utformade för att kalibrera och tillföra kontext och djup till den första bedömningen.
I slutändan får den rekryterande ledaren en bild av var kandidaten faktiskt befinner sig i förhållande till ett definierat kompetensramverk.
Fisher satte upp den primära byggmiljön i Lovable – en AI-byggare utan kod som skapar verktyg för allmänheten genom samtal, utan att låsa användarna till en specifik LLM – så att den tekniska arkitekturen kunde hålla jämna steg med gruppens tankar utan att bli en egen flaskhals.
Från ritning till bygge
Vid den fjärde sessionen utformade gruppen inte längre ett abstrakt verktyg. De byggde ett och upptäckte, som byggare alltid gör, att avståndet mellan idén och genomförandet är precis där det verkliga lärandet äger rum.
Fisher hade satt ihop en grundläggande anpassad GPT innan samtalet började, laddad med instruktioner, ett preliminärt kompetensramverk och början på den samtalslogik de hade kartlagt under tidigare sessioner. Planen var att alla skulle få tillgång till den, skriva uppmaningar till den tillsammans och börja kalibrera dess röst och beteende i realtid. Planen mötte verkligheten omedelbart.
Den delade länken fungerade inte för någon annan än mig. Behörigheter i arbetsytan, plattformsbegränsningar och det särskilda sätt på vilket ChatGPT hanterar extern åtkomst slukade den första fjärdedelen av sessionen.
Det var en liten frustration, precis den sortens sak som aldrig skulle hamna i ett produktmeddelande, och den var lärorik. Verktyg som yrkesverksamma faktiskt använder för att bygga saker fungerar inte som demonstrationer.
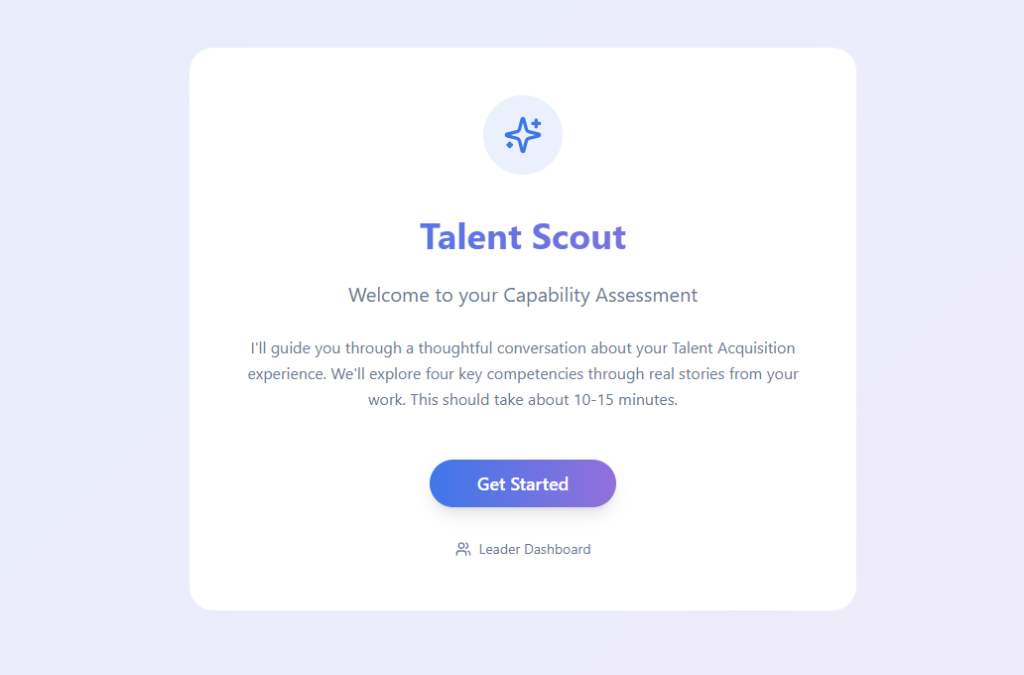
Den här skärmbilden visar hur välkomstskärmen så småningom skulle komma att se ut för verktyget som gruppen byggde, kallat Talent Scout.
När alla tittade på samma skärm hände något mer intressant. Medan gruppen fortfarande diskuterade vilket format kompetensdefinitionerna skulle ha, öppnade Gillies Claude i ett separat fönster och omvandlade poängsättningstabellen till strukturerad JSON – direkt under samtalet.
”Jag använder Claude eftersom det är bättre än ChatGPT för det här”, sa hon utan ceremonier. Några minuter senare släppte hon den formaterade filen i gruppchatten. Ingen stannade upp för att uppmärksamma det. De gick bara vidare.
Den typen av problemlösning i stunden – att omvandla ett hinder till ett löst problem utan att göra det till mötets huvudpunkt – är det som skiljer yrkesverksamma som verkligen har införlivat de här verktygen från dem som fortfarande lär sig att navigera i dem.
Vem får sista ordet
Satterfield tog upp en fråga som skulle få betydande konsekvenser både för verktygets arkitektur och för hur det så småningom skulle tas emot: är det AI:n som genererar det slutliga omdömet, eller bekräftar användaren det?
Skillnaden är inte kosmetisk. Om verktyget levererar ett omdöme som ”Baserat på dina svar befinner du dig på nivå 2 inom kandidatfokus”, positionerar det AI:n som auktoritet. Om det i stället visar en preliminär bedömning och bjuder in användaren att invända förändras dynamiken helt. Bedömningen blir samarbetsinriktad i stället för utvärderande. Användaren är en deltagare i processen, inte dess studieobjekt.
”Godkänner du den här återkopplingen?” sa Turnmeyer när idén föll på plats. ”Jag gillar den verkligen.”
Gillies byggde ut logiken. Om användaren inte godkänner bedömningen frågar verktyget vad som känns fel – och använder sedan svaret för att antingen kalibrera om eller varsamt bekräfta sin bedömning genom att gå igenom underlaget.
Det samtalsbaserade utbytet fram och tillbaka är det som skapar den psykologiska trygghet verktyget behöver för att vara genuint användbart. Människor förändras inte utifrån återkoppling de inte litar på. Att få med sig användaren är inte en mjuk funktion, det är själva mekanismen.
Det första riktiga testet
De bestämde sig för att testa prototypen live. Turnmeyer erbjöd sig att medvetet ge ett tunt svar på en av bedömningsfrågorna – den sortens svar som en oengagerad kandidat eller distraherad medarbetare skulle kunna ge.
Hon beskrev hur hon hade grälat med sin chef om en löneskillnad, förlorat kandidaten och inte hade någon aning om vad resultatet hade blivit. Det var HR-motsvarigheten till att svara ”Jag tycker verkligen om människor” när man får frågan varför man vill arbeta inom HR.
Verktyget bedömde det omedelbart. Det tilldelade en nivå. Det var uppmuntrande. Det var också fel, inte sakligt sett, utan förhastat. Det hade dragit slutsatser om vad svaret innebar i stället för att be om den ytterligare kontext som behövdes för att göra en korrekt bedömning.
Om du ska ge någon något annat än ”uppfyller förväntningarna” måste du ge detaljerade exempel. AI:n bör ställa samma krav på sig själv.
Erin Turnmeyer · Vicepresident för personalverksamhet
Turnmeyer drog parallellen direkt från sitt arbete med prestationsbedömningar. Hon hade länge krävt att chefer skulle ge specifika belägg innan de bedömde någon över eller under ”uppfyller förväntningarna”.
Samma disciplin bör gälla för verktyget. Innan det tilldelar en nivå måste det förtjäna rätten att göra det genom att ställa de frågor som skulle göra bedömningen försvarbar. Återigen var det HR-kompetensen i rummet som gjorde AI:n bättre – inte tvärtom.
Satterfield lade till en komplikation som verktyget hade förbisett. Det tunna svaret kunde ha återspeglat policy snarare än färdighet.
Om chefen faktiskt hade fastställt ett tak för ersättningen skulle det inte ha förändrat resultatet att argumentera hårdare. Verktyget hade bedömt personen när det borde ha frågat om situationen. Förtydligande frågor var inte en detalj för att putsa på resultatet. De var det som skulle skilja en användbar bedömning från en förmäten sådan.
Turnmeyer tog instruktionerna som hemuppgift: hur får man ett verktyg att ställa förtydligande frågor vid rätt tillfällen utan att varje interaktion känns som ett förhör?
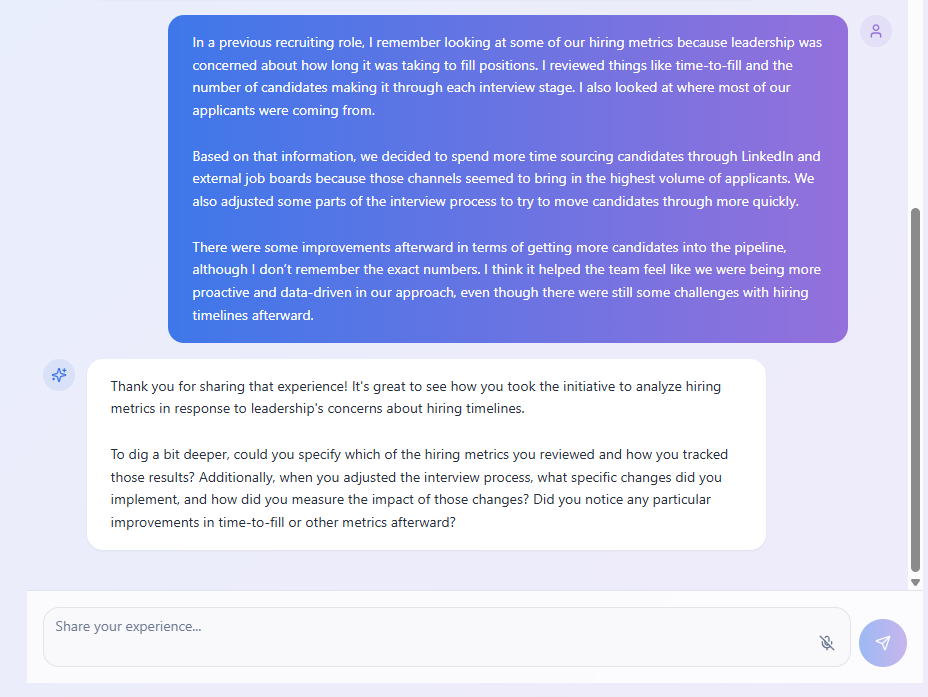
Den här skärmbilden visar ett exempel på vad slutprodukten skulle göra: ställa klargörande frågor och få kandidaten att gå in mer på djupet.
Det är ett svårare problem än det låter, och hon var mycket väl medveten om att ribban var ovanligt hög.
"Den måste vara bättre än en människa", sa hon. "Det är standarden."
Testning som disciplin
Sessionen gav också upphov till en av de mer praktiskt användbara metodologiska insikterna i hela gruppen. När Satterfield frågade hur gruppen vanligtvis testade verktyg som detta svarade både Turnmeyer och Gillies på sätt som avslöjade något viktigt om hur rigorös testning faktiskt ser ut i praktiken.
För sitt verktyg för rekommendationer om förmåner, som behövde visa korrekt huruvida specifika läkemedel omfattades av företagets sjukförsäkring, testade Turnmeyer specifikt gränsfallen. Inte de uppenbara läkemedlen, de populära som modellen hade stött på upprepade gånger under träningen. Hon testade de obskyra läkemedlen, i de kategorier som med störst sannolikhet skulle leda till en självsäker hallucination.
"Jag gick vidare och testade de mindre populära läkemedlen", sa hon, "eftersom Claude visade mig vad den gjorde medan den byggde det."
Den nivån av medveten motpartstestning är ovanlig hos personer som bygger verktyg utan bakgrund inom teknik. Den är också exakt det som skiljer verktyg som vinner förtroende från verktyg som tyst överges efter ett pinsamt misslyckande.
Att skala bort det du redan har byggt
En återgrupperingssession strax före helgerna började med en fråga som var svårare att ställa än den låter: vad är funktionen för att ladda upp CV egentligen till för?
Gillies tog upp frågan. Bedömningen bad användarna att tänka noga på sin egen kompetens. Tillförde CV:t information som användaren inte kunde lämna mer direkt genom att bara besvara frågorna? Ingen i gruppen var säker på att det gjorde det. Den ursprungliga avsikten hade varit att spara tid, ungefär som en CV-tolkare, men vi var inte längre övertygade om att den faktiskt levde upp till det.
De kom överens om att ta bort den.
Det här är ovanligare än det låter inom produktutveckling. Gruppen hade lagt betydande tid på uppladdningsfunktionen – byggt den, testat den och sett hur Satterfields CV tolkades och fick felaktiga poäng. Att ta bort den krävde att man åsidosatte den logik kring redan nedlagda kostnader som får team att fortsätta bygga vidare på sådant de redan har investerat i.
Börja med slutet i åtanke och definiera hur ett bra resultat ser ut. Om du inte kan formulera vad en funktion är till för kan du inte försvara den.
Turnmeyer framförde ett närliggande argument om metodik. I efterhand tänkte hon att de kanske hade kunnat arbeta snabbare genom att helt definiera verktygets beteende innan de skrev en enda prompt. De hade arbetat enligt något som liknade en agil modell – bygga, testa, justera – när komplexiteten i det de byggde kanske hade krävt mer av en vattenfallsmodell: få specifikationen rätt först och bygg sedan utifrån den.
Hon hade ett designdokument på 130 sidor från ett annat verktyg hon hade byggt, vilket hade lärt henne den här läxan. En komplett specifikation talar inte bara om vad du ska bygga. Den talar också om vad du inte ska bygga, vilket visar sig vara lika användbart.
Gillies preciserade produktens kärnproblem. Vad verktyget än visade på skärmen behövde det gå längre. En bedömning som visar data är inte samma sak som ett verktyg som berättar vad du ska göra med den. Det gapet mellan resultat och handling är där diagnostiska verktyg i tysthet slutar vara användbara, och det är ett gap som de flesta av dem aldrig sluter.
Att bygga ensam
I januari hade Satterfield gjort det mesta av byggandet själv, eftersom resten av gruppen hade känt att deras nio-till-fem-arbete tog för mycket tid för att lämna något utrymme kvar åt projektet. Ingen fick trots allt betalt för det här.
Hon hade tagit bort CV-uppladdningen, vilket gruppen hade kommit överens om. Hon hade lagt till röstinmatning – användarna kunde nu besvara bedömningsfrågorna genom att prata i stället för att skriva, vilket öppnade för en mer samtalslik svarsstil som var svårare att manipulera än ett textfält.
Hon hade använt ChatGPT för att generera syntetiska testsvar ("Jag är en juniorrekryterare som är stark inom det här och svag inom det här, ge mig svar"), för att sedan byta till Lovable och mata in svaren där och observera hur verktyget poängsatte dem.
Ledarinstrumentpanelen var den andra halvan av verktygets logik – vyn som en TA-chef eller CHRO skulle använda för att se hur en kandidat hade presterat, var luckorna fanns och hur kandidatens förmågor kunde komplettera styrkorna och behoven i ett befintligt team.
Det gjorde organisationsstrukturen till ett verkligt problem, eftersom verktyget behövde veta vem som bedömde vem och vem som hade behörighet att se resultaten.
Satterfield hade försökt hantera detta genom att be användarna ange sitt namn, sin jobbtitel och sin chefs namn (i avsaknad av en dataintegration). Men den logiken bröt ihop i ett vanligt scenario: en chef för talanganskaffning som ville skicka ut bedömningen till en bredare rekryteringsorganisation som omfattade både direkta och indirekta rapporteringsrelationer. Logiken för organisationskartläggningen var inte tillräckligt nyanserad för att ta hänsyn till den strukturen.
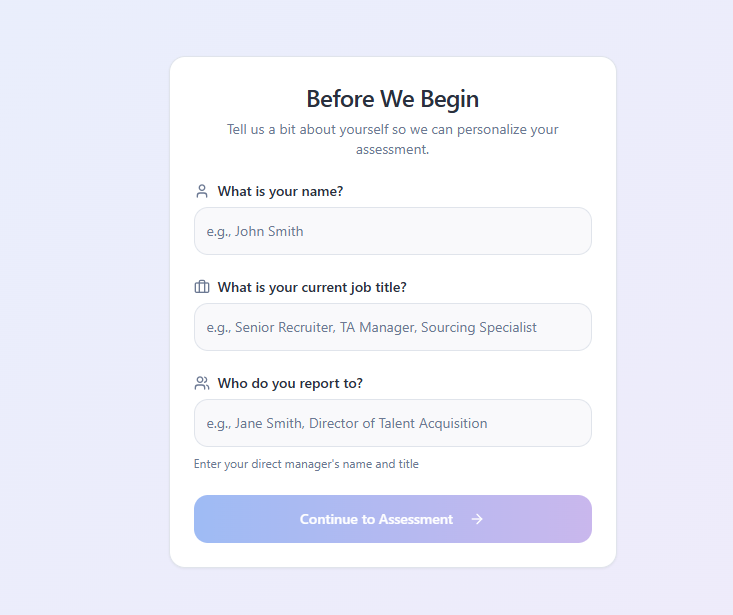
I teorin skulle den här informationen ge verktyget större insikt i bedömningsdeltagarens roll, men insamlingen av mer data gjorde saker och ting mer komplicerade.
Turnmeyer hade redan löst en version av det här problemet i ett annat sammanhang. Verktyget för prestationshantering som hon hade byggt för sitt eget företag körde på Google Sheets, Slack och Claude. Google Sheets lagrade data. Slack var gränssnittet som medarbetarna interagerade med. Claude hanterade analysen och genereringen av återkoppling.
Arkitekturen var enklare än den lät: ett kalkylblad med namn, e-postadress, jobbnivå och jobbtitel. En separat flik som korsrefererade jobbnivåer mot kompetenser.
”Säkerhetsavdelningen på mitt företag ville granska mitt verktyg”, berättade hon för gruppen. ”Jag sa att det var lagrat i Google Dokument. De sa: ’Jaha, det är så enkelt.’”
Enkelt, men Turnmeyer lärde sig det först genom att bygga. Det hon inte hade vetat tre veckor tidigare var att loggning fanns – en funktion som sparar en användares framsteg så att verktyget inte återställs när någon lämnar det och kommer tillbaka.
”Jag svor åt Claude”, sa hon, ”tills den berättade för mig att loggning fanns.
Det är det som byggande faktiskt lär en. Inte det du planerade att lära dig, utan det du inte visste att du behövde veta.
Frågan under ytan
Någon gång under januarisessionen kom samtalet fram till frågan som det hade kretsat kring i flera månader.
Gruppen fortsatte att diskutera arkitektur, behörigheter, lagring och instrumentpaneler – verkliga problem, allihop. Men under dem fanns ett mer grundläggande problem. Vad var det egentligen de försökte bygga, och för vem?
Verktyget, så som det ursprungligen hade utformats, var ett urvalsdiagnostikverktyg – något som en TA-ledare kunde skicka till en kandidat eller intern medarbetare för att bedöma om deras faktiska förmågor stämde överens med det som stod i deras CV, och synliggöra den bilden innan ett urvalsbeslut fattades.
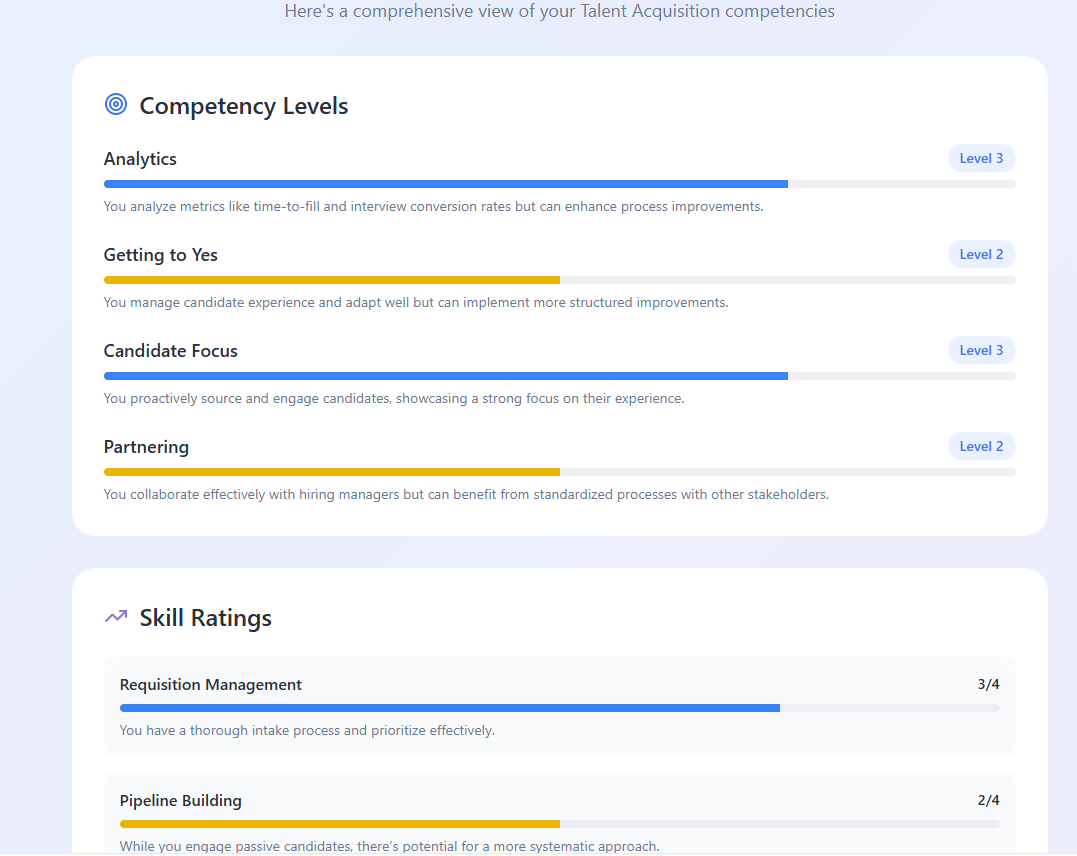


Det du ser här är ett urval av skärmbilder som visar den typ av rapport verktyget skapade för den intervjuade. För bedömaren hjälper en instrumentpanel med det aktuella teamets styrkor dem att fokusera på var de ska bedöma den intervjuade för att se om personen kan avhjälpa svagheter i TA-teamet.
Den kärnan hade inte förändrats. Men varje praktiskt beslut de hade fattat – att lägga till en ledarinstrumentpanel, fundera igenom prenumerationsmodeller och utarbeta ett inloggningsflöde – drog dem mot något mer komplext.
Instrumentpaneler i realtid innebar löpande åtkomst, vilket innebar prenumerationsavgifter, vilket i sin tur innebar att de närmade sig den typ av företagsverktyg som många organisationer har svårt att ha råd med eller införa på ett effektivt sätt.
”Vi försöker inte bli en HCM-leverantör”, sa Satterfield.
Turnmeyer var ärlig med var hon stod.
”Min avsikt var bara att lära mig något nytt.”
Det var inte ett tillbakadragande från projektet. Det var en korrekt beskrivning av vad experimentet redan hade gett henne. Hon hade lärt sig nya saker och höll redan på att bygga ett nytt verktyg för prestationshantering, där lärdomarna från gruppen hade tillämpats.
Hon behövde inte produktifiera gruppens verktyg för att ha fått ett verkligt värde av det.
I det här skedet var mitt eget intresse främst redaktionellt. Jag ville ha en berättelse att berätta och något som människor kunde titta på, inte en prenumerationsprodukt, utan en demonstration av att HR-praktiker kunde fundera över detta och kanske bygga något liknande.
Att skriva den här artikeln var en del av det. Kunde jag skapa en nedladdningsbar guide? Så småningom kanske ett liveevenemang där gruppen kunde diskutera vad de hade gjort, låta en publik interagera med verktyget och spela in samtalet som en podcast? Jag hade många idéer, men spelrummet för att genomföra dem när det nya årets mål hopade sig framför oss alla blev allt mindre.
Satterfields intresse var det mest kommersiellt inriktade, och hon var tydlig med det. Hon var intresserad av att så småningom produktifiera det. Hon tänkte inte göra det ensam. Men hon var villig att fortsätta bygga mot något som en dag skulle kunna säljas.
Den där trevägsdivergensen i avsikt – lärande, berättande, produkt – är förmodligen inneboende i alla grupper som denna. Det ärliga samtalet om den i januari var mer användbart än att låtsas att alla alltid hade velat samma sak.
Demon som svar
Frågan om hur man skulle låta människor prova verktyget hade förblivit olöst sedan uppladdningen av meritförteckningar lanserades. Det är värdefullt att testa med verkliga användare, men det skapar sina egna problem. Verktyget måste fungera konsekvent, användarna behöver tillräckligt med sammanhang för att förstå vad de gör, och det är svårt att återhämta sig från en dålig första upplevelse.
Turnmeyer erbjöd den enklaste lösningen som gruppen hade övervägt.
Hon hade tittat på demoinspelningar – korta genomgångar på en eller två minuter som visade hur ett verktyg fungerade utan att kräva att tittaren faktiskt använde det. Hon föreslog att det kanske kunde räcka. Människor kunde se verktyget i praktiken, förstå vad det gjorde och varför, och gå därifrån med känslan av att det var möjligt.
De skulle inte behöva navigera genom en inloggning, ange ett organisationsschema eller fastna när en bedömningsfråga inte stämde överens med deras situation.
Den feedback jag får från många av bloggarna jag skriver är att människor egentligen inte vill kopiera och klistra in exakt samma sak. De vill bara veta att de kan göra det.
Erin Turnmeyer · VP för personalverksamhet
Den observationen pekar på något verkligt i hur HR-praktiker förhåller sig till AI-verktyg just nu. Klyftan som många av dem navigerar i ligger inte mellan att veta att något existerar och att använda det. Den ligger mellan att tro att de över huvud taget är kapabla att göra något sådant.
En demo som visar praktiker bygga sitt eget verktyg besvarar en annan fråga än en färdig produkt – inte ”är det här verktyget bra?” utan ”skulle någon som jag ha kunnat skapa det?”
Idén togs emot väl. Den hanterade farhågorna kring testning, minskade komplexiteten i att dela något som inte var produktionsklart och höll fokus där gruppen alltid hade avsett att det skulle ligga: på processen och tänkandet, inte bara resultatet.
Vad experimentet lärde oss: En guide för HR-byggare
- Börja med problemet, inte tekniken. Gruppens tidiga entusiasm för sentimentanalys var genuin, och den ledde dem bort från ett mer hanterbart och värdefullt problem. Övergången till kompetenskartläggning fungerade eftersom den utgick från ett verkligt användningsfall som redan hade testats i praktiken.
- Skräddarsytt slår generiskt. Varje deltagare hade stött på begränsningarna hos HR-plattformar för företag. Verktygen som byggdes för specifika sammanhang – Turnmeyers förmånsrekommendation, Satterfields värmekarta – presterade bättre än standardalternativen. Argumentet för att bygga själv är starkare än någonsin, och hindren är lägre.
- Korskontrollen är hela poängen. Självskattningar är bara så bra som människors självkännedom, som är notoriskt opålitlig. Ett verktygs verkliga värde ligger i dess förmåga att undersöka, utmana och varsamt kalibrera om – inte bara registrera vad människor tror om sig själva.
- Minimalt värdefullt, inte minimalt gångbart. Om den första versionen inte levererar något som får en användare att vilja återvända spelar färdplanen ingen roll. Utforma för det första intrycket, inte det femte.
- Förankring är strukturell, inte mjuk. Frågan om huruvida AI:n genererar det slutliga betyget eller om användaren bekräftar det är inte en UX-detalj. Den avgör om verktyget är en auktoritet eller en samarbetspartner, och den skillnaden formar allt kring hur det tas emot och används.
- Ta bort funktioner som ni redan har byggt. Logiken kring redan nedlagda kostnader får team att fortsätta bygga ut sådant de har investerat i långt efter att det har slutat förtjäna sin plats. Om ni inte kan formulera vad en funktion är till för, så har ni svaret. Att ta bort den är produktdisciplin, inte ett misslyckande.
- Testa motståndskraftigt och tidigt. Hitta människor som kommer att säga att verktyget är dåligt. Ge det den värsta rimliga indata ni kan föreställa er och se vad det gör. Bygg in gränsfallen innan ni putsar de typiska fallen. Verktygets trovärdighet beror på hur det hanterar de ögonblick som det inte utformades för.
- Verktyget ska förtjäna rätten att bedöma. Att hoppa till ett betyg innan man har ställt tillräckligt många frågor är förmätenhet, inte effektivitet. Förtydligande frågor är det som gör bedömningen försvarbar, och försvarbarhet är det som gör att återkopplingen får fäste.
- Var ärlig om varför alla är där. Skilda avsikter inom en grupp är inte ett problem som ska hanteras – de är information. Att få upp dem på bordet tidigt besparar alla att bygga mot ett mål som bara vissa av dem faktiskt delar.
- De svåraste samtalen är de viktigaste. Gruppen byggde ett verktyg för att bedöma HR-kompetenser och hade genom det ett av de ärligaste samtalen om HR:s begränsningar som någon av dem kunde minnas. Det samtalet – om bakåtblickande ramverk, om klyftan mellan kunskap från prov och situationsbaserat omdöme – var produkten lika mycket som verktyget.
Sessionerna som började som ett åtagande på fyra samtal sträckte sig in i vintern och sedan in i det nya året. Prototypen utvecklades fortfarande. Avsikterna hos människorna som hade byggt den hade klarnat på sätt som inte gick att lösa på ett enkelt sätt.
Satterfield byggde fortfarande. Turnmeyer hade tagit det hon lärt sig och tillämpat det på annat håll. Gillies hade drivit gruppen till att vara mer disciplinerad kring vad verktyget faktiskt skulle göra. Jag skrev berättelsen om alltihop.
Turnmeyer hade sagt något tidigt i processen som fortfarande stämde: hon byggde inte för att hon hade blivit ombedd att göra det, utan för att hon behövde förstå.
Den förståelsen av vad AI-verktyg faktiskt gör, vad de gör fel och vad som krävs för att göra dem användbara, fanns inte i någon konferenssession eller produktdemonstration. Den kom från de beslut gruppen fattade, funktionerna de tog bort, stunderna när verktyget bedömde någon fel och de var tvungna att ta reda på varför.
Det mest användbara som gruppen producerade fanns inte i prototypen. Det fanns i resonemanget bakom den.

