Key Takeaways
Mudança Fundamental: A Upwork vende agora a execução de trabalho, onde os sistemas combinam pessoas e máquinas para alcançar resultados, em vez de preencher funções.
Limitações da Avaliação Comparativa: A avaliação comparativa da automatização da Upwork testou trabalhos selecionados e de baixa complexidade, pelo que os seus resultados não podem representar a maior parte do trabalho realizado na plataforma.
Valor Humano: O feedback humano melhorou a conclusão pelos agentes, mas exigiu substancialmente mais tempo e nunca produziu um sucesso fiável em todos os trabalhos.
Lacuna na Verificação: A automatização funciona melhor quando os resultados têm verificações objetivas; o trabalho que exige muita avaliação e envolve várias áreas continua a precisar de uma pessoa responsável.
Teste Empresarial: Avalie a automatização pelos resultados aceites, contabilize a revisão especializada como produção e proteja as funções intermédias que desenvolvem a avaliação futura.
A Upwork deixou de se chamar um mercado de talentos. Agora, o termo é “plataforma de entrega de trabalho”, e a mudança vai além do posicionamento.
Num mercado, um cliente contrata uma pessoa. Numa plataforma de entrega de trabalho, um cliente define um resultado e o sistema decide que combinação de pessoas e máquinas o produz.
Andrew Rabinovich, que lidera a área de IA na Upwork, descreve a unidade que está a ser comprada como algo menor do que um emprego e menor do que uma função. Duas décadas de dados da plataforma, afirmou na AI4, sugerem que a enorme variedade de trabalho publicado na Upwork se decompõe em cerca de 500 a 1.000 tarefas recorrentes. Chama-lhes “unidades atómicas de trabalho”, funções de base que se recombinam em qualquer tarefa que um cliente possa publicar.
Uma empresa que pretenda vender trabalho decomposto assume uma obrigação. Tem de saber que partes decompostas uma máquina consegue concluir sozinha e tem de o saber com precisão suficiente para investir dinheiro nessa resposta.
Por isso, a Upwork submeteu trabalhos reais de clientes a um teste de referência, publicou os resultados como o Índice de Produtividade Humana+Agente e documentou a metodologia num artigo divulgado através do arXiv em dezembro.
A principal conclusão é aquilo que os agentes concluíram. A conclusão mais útil é o custo necessário para que o concluam e quem acaba por suportar esse custo.
O trabalho mais favorável à automatização
A metodologia merece mais atenção do que os resultados, porque estabelece o limite máximo do que os resultados podem significar.
A Upwork selecionou 322 trabalhos reais já publicados por clientes pagadores e já concluídos com a aceitação dos clientes por profissionais independentes humanos. Profissionais independentes especialistas elaboraram uma grelha de avaliação para cada um, com entre 5 e 20 critérios de aceitação, classificados como críticos, importantes, opcionais e problemas a evitar. Um trabalho só era considerado concluído se todos os critérios críticos e importantes fossem cumpridos.
Três modelos realizaram o trabalho: Claude, Gemini e GPT-5.
É nos critérios de seleção que um executivo deve prestar atenção. Os trabalhos estavam limitados a contratos de preço fixo, com um único marco e um âmbito claramente definido. As durações variavam entre nove horas e mais de 100 dias, pelo que não se tratava uniformemente de microtarefas. O trabalho aberto e complexo foi excluído com o fundamento declarado de que os agentes não tinham uma probabilidade razoável de o executar.
A Upwork descreve essa categoria excluída como a grande maioria do trabalho realizado na plataforma.
Há mais uma limitação importante para quem esteja prestes a rejeitar os resultados. Os agentes foram mantidos deliberadamente básicos. Cada um leu a publicação do trabalho e quaisquer anexos, elaborou um plano, produziu um resultado e parou. Não fizeram pesquisas na Internet, não tiveram acesso a dados externos, não utilizaram ferramentas adicionais nem receberam formação sobre o tipo de tarefa.
Como resultado, os autores observam que as conclusões não são representativas de sistemas ricos em ferramentas e descrevem os seus próprios números como estimativas conservadoras.
Assim, todos os valores abaixo foram medidos com base no trabalho mais simples disponível, depois de os casos difíceis terem sido previamente removidos, utilizando agentes desprovidos das ferramentas que a maioria das empresas realmente implementa.
Have an account? Log In
O apoio administrativo é mais difícil do que parece
A trabalhar sozinhos, os agentes cumpriram todos os critérios em entre 4% e 68% dos trabalhos, dependendo da categoria e do modelo. O desenvolvimento para a Web e de software ficou no topo. A ciência de dados ficou logo atrás.
O apoio administrativo ficou em último lugar, em média, entre os três modelos, com uma pontuação de 6% em dois deles.
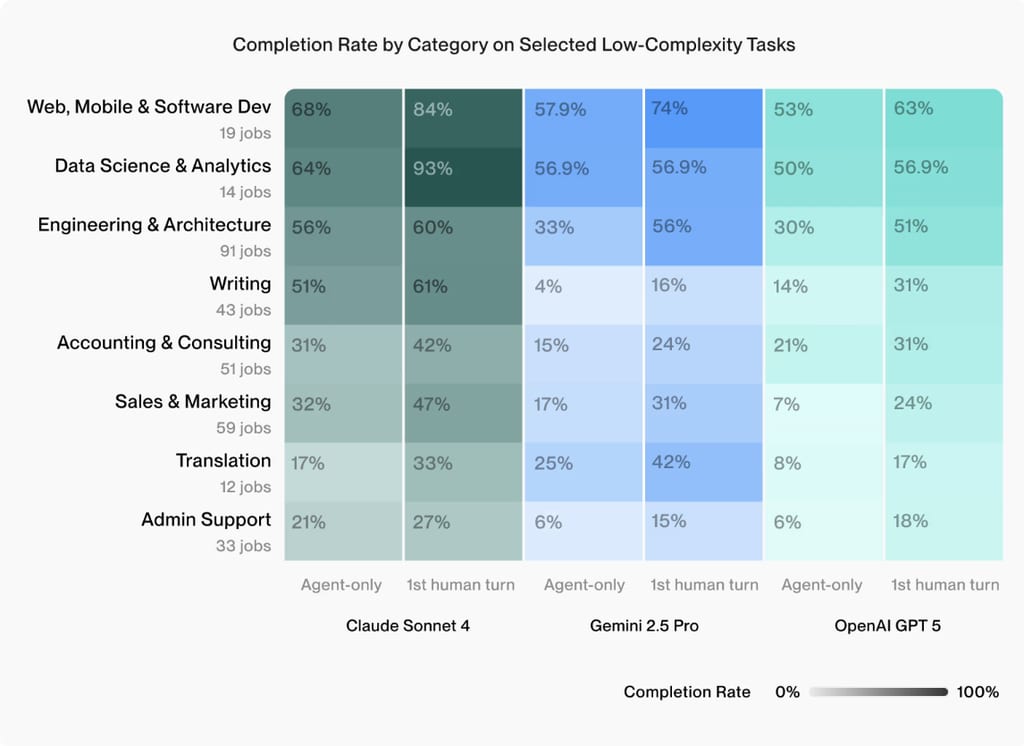
Essa ordem contradiz diretamente a forma como a maioria dos roteiros de automatização é normalmente estruturada. O trabalho administrativo é o primeiro alvo, partindo do pressuposto razoável de que é a tarefa mais simples do edifício.
O teste de referência sugere que ser simples de descrever e ser simples de verificar são propriedades distintas, e apenas a segunda prevê se um agente consegue concluir o trabalho.
A própria formulação de Rabinovich mostra como é fácil fazer essa suposição. Questionado sobre o efeito nos profissionais independentes, descreveu o trabalho de baixo nível, como criar logótipos e escrever resumos de coisas, como algo que já foi completamente automatizado. O teste de referência da sua empresa atribuiu à escrita uma pontuação entre 4% e 51%, dependendo do modelo, com o Gemini no limite inferior desse intervalo. A intuição e a medição apontam em direções diferentes.
A adição de uma ronda de comentários especializados aumentou a conclusão global em todos os modelos. O Claude passou de 39,8% para 51,2% nas tarefas de baixa complexidade após apenas uma intervenção humana. O Gemini passou de 19,9% para 32,3%. O GPT-5 passou de 19,6% para 33,5%. Em termos absolutos, isso representa uma melhoria de 11 a 14 pontos percentuais resultante de uma única intervenção humana.
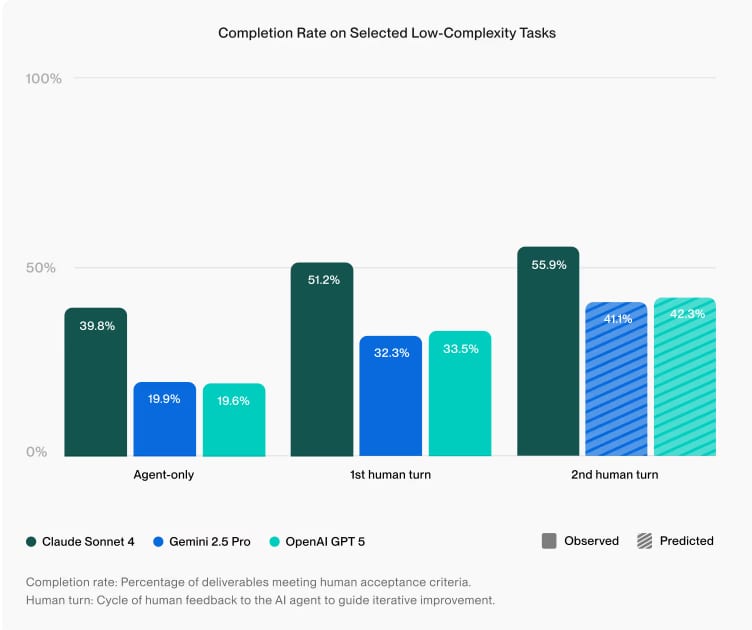
A Upwork apresenta o topo do intervalo relativo como um aumento de até 70%, o que corresponde a uma aritmética correta face à base de referência baixa do GPT-5 e vale a pena ler em conjunto com os valores absolutos.
A evolução ao nível das categorias foi desigual. A conclusão de tarefas de ciência de dados do Claude passou de 64% para 93%. A escrita do Gemini passou de 4% para 16%. O desempenho do Gemini em ciência de dados não se alterou.
Nada atingiu os 100%. Nem sequer nas tarefas mais fáceis disponíveis, com um especialista a orientá-lo.
A verificação é a parte que ainda não resolvemos
Rabinovich coloca a percentagem de trabalho qualitativo na plataforma acima dos 90% e é direto quanto ao que isso significa para a avaliação. O trabalho determinístico tem a sua própria verificação. Uma tradução pode ser verificada por outro modelo. O código compila e passa nos testes, ou não. Para tudo o resto, a única verificação disponível é uma pessoa com capacidade de julgamento a analisar o resultado e a decidir se tem qualidade.
Descreveu esta questão como algo em grande medida por resolver, e foi mais longe.
Resolva a validação fiável de resultados qualitativos e terá, mais ou menos, resolvido a IA.
Os autores do artigo são cuidadosos quanto ao que os seus próprios números demonstram neste ponto. Não realizaram segundas tentativas correspondentes apenas com agentes nas tarefas que falharam, o que significa que não é possível separar a melhoria do efeito de simplesmente permitir que o modelo tente novamente. Essa é a sua divulgação, incluída nas limitações do estudo.
O estudo de referência demonstra algo mais restrito do que o enquadramento da Upwork sugere. Uma segunda tentativa após os comentários de um especialista supera uma primeira tentativa. Não foi medido quanto desse resultado se deve aos comentários e quanto se deve à nova tentativa.
O limite máximo é a conclusão duradoura. Em condições selecionadas para favorecer o sucesso do agente, aproximadamente uma em cada cinco tarefas que falharam inicialmente foi recuperada através de uma segunda tentativa orientada por uma pessoa, e a conclusão atingiu um máximo de 51% no modelo mais forte. As execuções orientadas por pessoas também demoraram cerca de quatro vezes mais: 14,5 minutos contra 3,6.
A própria decisão de produto da Upwork aponta na mesma direção. A UMA, o principal sistema de IA da empresa, foi concebida como um agente de orquestração e não como um trabalhador. Interpreta a intenção, decompõe-na, encaminha as partes para pessoas ou máquinas e verifica o resultado. Não executa a tarefa.
Uma empresa com todos os incentivos comerciais para vender execução autónoma concebeu o seu sistema central com base no pressuposto de que uma pessoa continua envolvida no trabalho.
Duas perguntas antes de financiar um fluxo de trabalho
Há duas perguntas fundamentais que é importante fazer sobre aquilo que pretende que os agentes façam.
É possível verificar o resultado comparando-o com algo objetivo? Um conjunto de testes, uma reconciliação, uma regra de conformidade, um número que corresponde ou não corresponde.
O trabalho permanece dentro de uma única função e de um único formato? Ou passa da retaguarda para a interface, depois para o texto e para a aprovação da marca antes de alguém o poder considerar concluído?
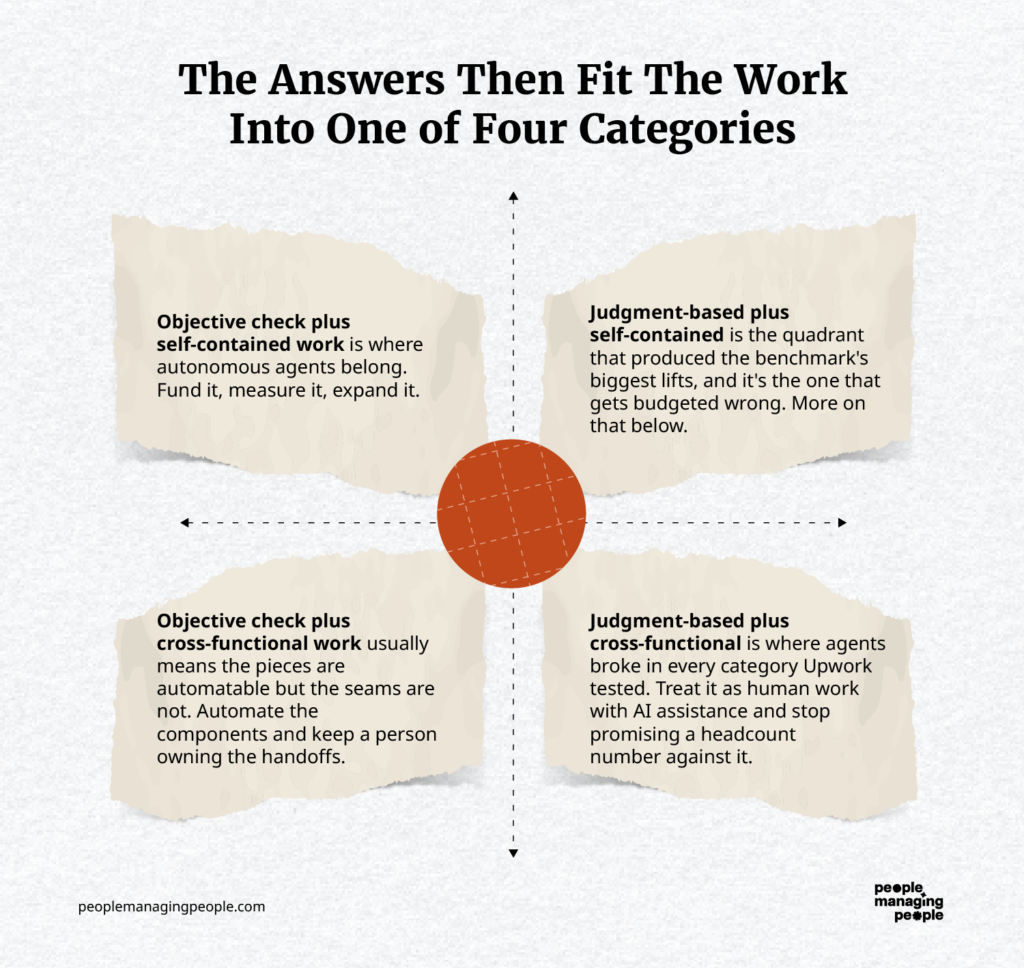
Verificação objetiva mais trabalho autónomo é onde os agentes autónomos se enquadram. Financie-o, meça-o e expanda-o.
Verificação objetiva mais trabalho interfuncional normalmente significa que os componentes podem ser automatizados, mas as ligações entre eles não. Automatize os componentes e mantenha uma pessoa responsável pelas transições.
Baseado em julgamento mais autónomo é o quadrante que produziu os maiores ganhos do estudo de referência e é aquele que recebe um orçamento inadequado. Mais sobre isso abaixo.
Baseado em julgamento mais interfuncional é onde os agentes falharam em todas as categorias testadas pela Upwork. Trate-o como trabalho humano com assistência de IA e deixe de prometer um número de trabalhadores necessário para o executar.
A própria modelação económica da Upwork chega aproximadamente à mesma conclusão. Os agentes sozinhos vencem em tarefas de baixo valor, nas quais o custo da falha é reduzido; a colaboração vence no meio; e a execução totalmente humana vence no trabalho de elevado valor, em que um resultado inadequado custa mais do que aquilo que a automação poupa.
A tarefa que a Upwork escolheu mostrar
A página HAPI inclui cinco tarefas de exemplo com entregáveis que pode descarregar. Uma é uma tarefa de geração de contactos. Filtrar uma folha de cálculo de aplicações móveis para identificar as que têm sede nos EUA, encontrar dois a quatro contactos de marketing em cada uma e preencher nove colunas identificadas.
Objetivamente verificável. Uma única função, um único formato. Os critérios da grelha de avaliação estão visíveis na página e nenhum deles exige gosto pessoal.
Ambos os resultados foram considerados reprovados na avaliação. O agente a trabalhar sozinho falhou. O agente a trabalhar com um especialista, um freelancer que o orientava, também falhou.
A Upwork colocou isso na sua própria página de marketing, ao lado de uma afirmação de que a colaboração aumenta a conclusão em até 70%. É justo reconhecer o mérito da empresa pela divulgação e retirar daí a lição, porque esse trabalho corresponde de perto ao tipo de trabalho que as empresas já estão a atribuir a um agente.
A Pessoa Certa no Processo?
Todos os fornecedores vendem o humano no processo como uma funcionalidade de segurança. Leia os critérios dos avaliadores e surge uma pergunta diferente.
Todos os avaliadores da Upwork tinham uma pontuação de sucesso profissional de 100%, com o estatuto Top Rated ou Top Rated Plus. Em conjunto, tinham ganho mais de 1 milhão de dólares na plataforma, ao longo de mais de 96 000 horas.
Isso representa o topo de um mercado global de talento. É também a única população de avaliadores testada. O artigo observa que a equipa não traçou o perfil da experiência dos avaliadores nem estudou de que forma o percurso de um avaliador altera o valor do seu feedback. Não houve uma condição com avaliadores juniores.
Assim, todos os números do estudo descrevem o melhor cenário para a supervisão humana, e o efeito de atribuir essa função a quem tivesse disponibilidade não foi medido por ninguém.
Esse é o meu argumento, e não o do estudo de referência, e dele resultam duas consequências que a maioria dos planos de força de trabalho ainda não contabilizou.
A primeira é que a revisão representa capacidade de produção, não custos gerais. No quadrante baseado no discernimento, o especialista não é um ponto de verificação acrescentado a um processo automatizado. O especialista é o elemento de entrada que transforma um rascunho em algo pronto para entregar, e a diferença de quatro vezes no tempo entre as duas condições é o custo desse elemento.
Se a classificarmos como supervisão, subestimamos o fluxo de trabalho e sobrestimamos as poupanças. A matemática que justificou o investimento deixa de descrever o processo que realmente construímos.
A segunda consequência é mais lenta e pior. Todos os planos que reduzem as funções intermédias para financiar despesas com IA estão também a reduzir a população que, dentro de três anos, se tornaria suficientemente sénior para contrariar um modelo.
O discernimento especializado não é uma credencial, é um resíduo. Acumula-se através da realização do trabalho, mal no início, com alguém mais experiente a corrigi-lo. Automatize os primeiros degraus e manterá os avaliadores de hoje, mas eliminará o mecanismo que produz os de amanhã.
Isso é um problema de liderança antes de ser um problema de pessoal, e cabe a quem aprova o plano de negócio da automatização.
More Articles
- Como utilizar o ProdoAI: transformar dados brutos em orientação inteligente para a força de trabalho
- IA de Processamento Salarial do QuickBooks Workforce: Análise Aprofundada das Funcionalidades e Como Funciona
- Como mudar de fornecedor de EOR sem interrupções: processo em 7 passos
- As avaliações de desempenho não têm de se arrastar
- Como a Justworks ajuda as pequenas empresas a passar do processamento salarial manual para o automatizado
Se os Agentes se Tornarem Compradores, o Discernimento é o Produto
A leitura de Rabinovich sobre o rumo que este mercado tomará a seguir é que os agentes se tornarão uma fonte de procura, em vez de serem apenas uma fonte de oferta. Um modelo que esteja a realizar uma tarefa que não consegue verificar — uma questão médica, uma recomendação de restaurante ou qualquer outra coisa que dependa do gosto pessoal — contrata um humano em tempo real para a verificar. O humano não entrega o projeto; limita-se a validar o resultado.
É um executivo de uma plataforma a descrever o potencial da sua própria empresa, e isso deve ser ponderado como tal.
A implicação para a força de trabalho mantém-se, independentemente de o mecanismo surgir dessa forma. Se a verificação for o contributo humano duradouro, então as funções que conservam valor são definidas pelo discernimento sobre a qualidade dos resultados, e não pelo volume de produção.
Atualmente, essas funções estão dispersas por níveis de senioridade, famílias profissionais e centros de custos que muitas vezes não são mapeados, o que significa que a maioria das organizações não consegue dizer quem as desempenha nem quanto custaria substituí-las.
Quatro Medidas
Então, o que pode fazer para avaliar se está preparado para começar a delegar tarefas a agentes, de modo a que estes concluam pelo menos parte do trabalho?
- Retire dez resultados do seu fluxo de trabalho mais automatizado e coloque-os diante de quem anteriormente era responsável por esse trabalho. Pergunte quantos teriam enviado a um cliente sem alterações. Esse número é a sua verdadeira taxa de automatização.
- Para cada fluxo de trabalho automatizado, identifique a pessoa com autoridade para rejeitar o resultado. Depois, verifique se essa pessoa pode exercer essa autoridade sem fazer uma escalada.
- Reclassifique o tempo de revisão nos fluxos de trabalho que se enquadram no quadrante do discernimento. Transfira-o da supervisão para a produção e volte a calcular o plano de negócio.
- Leia os contratos com os seus fornecedores para perceber o que significa conclusão. A aceitação avaliada segundo uma grelha, face a todos os critérios, e a afirmação de que uma “tarefa foi tentada” são afirmações diferentes, e apenas uma delas corresponde ao que o estudo de referência mediu.