

Det kan dine agenter ikke færdiggøre uden dig

Det grundlæggende skifte: Upwork sælger nu levering af arbejde, hvor systemer kombinerer mennesker og maskiner for at opnå resultater frem for at udfylde roller.
Benchmarkens begrænsninger: Upworks automatiseringsbenchmark testede udvalgte opgaver med lav kompleksitet, så resultaterne kan ikke repræsentere det meste arbejde på platformen.
Menneskelig værdi: Menneskelig feedback forbedrede agenternes færdiggørelse, men krævede betydeligt mere tid og førte aldrig til pålidelige resultater på tværs af alle opgaver.
Verifikationskløften: Automatisering fungerer bedst, når resultaterne kan kontrolleres objektivt; arbejde, der kræver dømmekraft og går på tværs af funktioner, har stadig brug for et ansvarligt menneskeligt ejerskab.
Forretningsmæssig test: Mål automatisering ud fra accepterede resultater, prissæt ekspertgennemgang som en del af produktionen, og beskyt roller på mellemniveau, der udvikler fremtidig dømmekraft.
Upwork har holdt op med at kalde sig selv en talentmarkedsplads. Nu er betegnelsen "platform for levering af arbejde", og ændringen handler om mere end positionering.
På en markedsplads ansætter en kunde en person. På en platform for levering af arbejde angiver en kunde et resultat, og systemet beslutter, hvilken kombination af mennesker og maskiner der skal producere det.
Andrew Rabinovich, som leder AI hos Upwork, beskriver den enhed, der købes, som noget mindre end et job og mindre end en rolle. To årtiers platformdata tyder ifølge ham på, som han sagde ved AI4, at den enorme variation af arbejde, der slås op på Upwork, kan opdeles i omtrent 500 til 1.000 tilbagevendende opgaver. Han kalder dem "atomare arbejdsenheder", basisfunktioner, der kan kombineres på ny til enhver opgave, en kunde måtte slå op.

En virksomhed, der har til hensigt at sælge opdelt arbejde, påtager sig en forpligtelse. Den skal vide, hvilke opdelte dele en maskine kan færdiggøre på egen hånd, og den skal vide det med tilstrækkelig præcision til at sætte penge bag svaret.
Så Upwork kørte reelle kundeopgaver gennem en benchmarkmåling, offentliggjorde resultaterne som produktivitetsindekset for mennesker og agenter og dokumenterede metoden i en artikel udgivet via arXiv i december.
Den vigtigste konstatering er, hvad agenterne færdiggjorde. Den mere nyttige konstatering er, hvad det koster at få dem til at færdiggøre det, og hvem denne omkostning viser sig at tilfalde.
Det arbejde, der egner sig bedst til automatisering
Metoden fortjener mere opmærksomhed end resultaterne, fordi den sætter loftet for, hvad resultaterne kan betyde.
Upwork udvalgte 322 reelle opgaver, som allerede var slået op af betalende kunder og allerede færdiggjort og accepteret af kunderne efter udførelse af menneskelige freelancere. Ekspertfreelancere skrev en vurderingsrubrik for hver af dem med mellem 5 og 20 acceptkriterier, inddelt i kritiske, vigtige, valgfrie og faldgruber. En opgave blev kun regnet som færdig, hvis alle kritiske og vigtige kriterier var opfyldt.
Tre modeller udførte arbejdet: Claude, Gemini og GPT-5.
Det er ved udvælgelseskriterierne, at en leder bør sætte tempoet ned. Opgaverne var begrænset til fastpriskontrakter med én milepæl og klart defineret omfang. Varigheden strakte sig fra ni timer til mere end 100 dage, så der var ikke tale om ensartede mikrootgaver. Åbent og komplekst arbejde blev udelukket med den begrundelse, at agenterne ikke havde en rimelig chance for at klare det.
Upwork beskriver denne udelukkede kategori som langt størstedelen af det arbejde, der udføres på platformen.
Endnu en begrænsning er vigtig for enhver, der er på vej til at afvise resultaterne. Agenterne blev bevidst holdt på et grundlæggende niveau. Hver agent læste jobopslaget og eventuelle bilag, lagde en plan, producerede en leverance og stoppede. Ingen websøgning, ingen adgang til eksterne data, ingen yderligere værktøjer og ingen træning i opgavetypen.
Som følge heraf bemærker forfatterne, at resultaterne ikke er repræsentative for systemer med mange værktøjer, og de beskriver deres egne tal som konservative estimater.
Så alle nedenstående tal blev målt på det mest overskuelige tilgængelige arbejde, hvor de svære tilfælde var fjernet på forhånd, ved hjælp af agenter, der var frataget de værktøjer, som de fleste virksomheder faktisk anvender.
Administrativ support er sværere, end det ser ud
Ved at arbejde alene opfyldte agenterne alle kriterier på mellem 4 og 68 % af opgaverne afhængigt af kategori og model. Web- og softwareudvikling lå øverst. Datavidenskab fulgte lige efter.
Administrativ support lå i gennemsnit sidst på tværs af de tre modeller med en score på 6 % for to af dem.
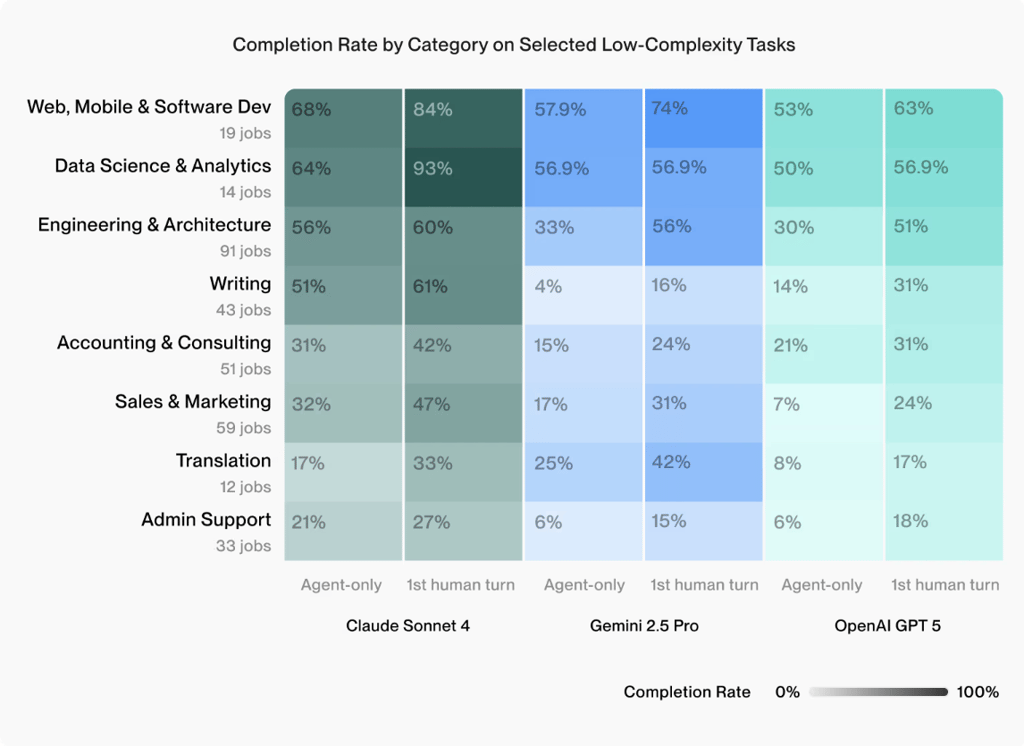
Denne rækkefølge går direkte imod den måde, de fleste automatiseringsplaner bliver prioriteret på. Administrativt arbejde målrettes først ud fra den rimelige antagelse, at det er den enkleste opgave i bygningen.
Benchmarkmålingen antyder, at det at være enkelt at beskrive og det at være enkelt at verificere er to forskellige egenskaber, og kun den sidstnævnte forudsiger, om en agent kan færdiggøre opgaven.
Rabinovichs egen formulering viser, hvor let antagelsen er at drage. Da han blev spurgt om effekten på freelancere, beskrev han arbejde på lavt niveau, som at lave logoer og skrive opsummeringer af ting, som noget, der allerede var blevet fuldstændig automatiseret væk. Hans virksomheds benchmarkmåling gav skrivearbejde en score på mellem 4 % og 51 % afhængigt af modellen, hvor Gemini lå i bunden af dette interval. Intuitionen og målingen peger i forskellige retninger.
En runde med ekspertfeedback øgede den samlede færdiggørelsesgrad for alle modeller. Claude gik fra 39,8 % til 51,2 % på opgaver med lav kompleksitet efter blot én menneskelig indgriben. Gemini gik fra 19,9 % til 32,3 %. GPT-5 gik fra 19,6 % til 33,5 %. Målt absolut svarer det til en forbedring på 11 til 14 procentpoint efter én enkelt menneskelig involvering.

Upwork markedsfører toppen af det relative interval som en stigning på op til 70 %, hvilket er korrekt regnet ud fra GPT-5's lave udgangspunkt og bør læses sammen med de absolutte tal.
Udviklingen på kategoriniveau var ujævn. Claudes gennemførelse inden for datavidenskab steg fra 64 % til 93 %. Geminis skrivning steg fra 4 % til 16 %. Geminis datavidenskab rykkede sig slet ikke.
Intet nåede 100 %. Ikke engang inden for det lettest tilgængelige arbejde, med en ekspert til at vejlede det.
Verifikation er den del, vi ikke har løst
Rabinovich anslår den kvalitative andel af arbejdet på platformen til over 90 %, og han er direkte omkring, hvad det betyder for evalueringen. Deterministisk arbejde har sin egen kontrol. En oversættelse kan verificeres af en anden model. Kode kompilerer og består enten testene, eller også gør den ikke. For alt andet er den eneste tilgængelige verifikation en person med dømmekraft, der ser på resultatet og beslutter, om det er godt nok.
Han beskrev dette som stort set uløst og gik videre.
Løs pålidelig validering af kvalitative resultater, så har du mere eller mindre løst AI.
Forfatterne til rapporten er omhyggelige med, hvad deres egne tal beviser på dette punkt. De gennemførte ikke sammenlignelige forsøg, hvor kun agenter blev anvendt, på de opgaver, der mislykkedes, hvilket betyder, at forbedringen ikke kan adskilles fra effekten af blot at lade modellen prøve igen. Det er deres oplysning, anført under begrænsninger.
Det, benchmarken fastslår, er mere begrænset, end Upworks formulering antyder. Et andet forsøg efter ekspertfeedback klarer sig bedre end et første forsøg. Hvor meget der skyldes feedbacken, og hvor meget der skyldes det nye forsøg, er ikke målt.
Loftet er det varige fund. Under betingelser udvalgt til at fremme agentsucces blev omtrent én ud af fem oprindeligt mislykkede opgaver reddet af et menneskevejledt andet forsøg, og gennemførelsen toppede ved 51 % for den stærkeste model. De menneskevejledte kørsler tog også omkring fire gange så lang tid, 14,5 minutter mod 3,6.
Upworks egen produktbeslutning peger i samme retning. UMA, virksomhedens flagskib inden for AI-systemer, blev bygget som en orkestreringsagent snarere end en udførende agent. Den fortolker intentioner, opdeler dem, sender dele til mennesker eller maskiner og kontrollerer resultatet. Den udfører ikke opgaven.
En virksomhed med alle kommercielle incitamenter til at sælge autonom levering designede sit centrale system ud fra antagelsen om, at et menneske forbliver involveret i arbejdet.
To spørgsmål, før du finansierer en arbejdsgang
Der er to vigtige spørgsmål, som det er vigtigt at stille om det, du vil have agenter til at gøre.
Kan resultatet kontrolleres op imod noget objektivt? En testpakke, en afstemning, en regel for overholdelse eller et tal, der enten stemmer eller ikke stemmer.
Forbliver arbejdet inden for én funktion og ét format? Eller bevæger det sig fra systemets bagende til brugerfladen til tekst til brandgodkendelse, før nogen kan kalde det færdigt?
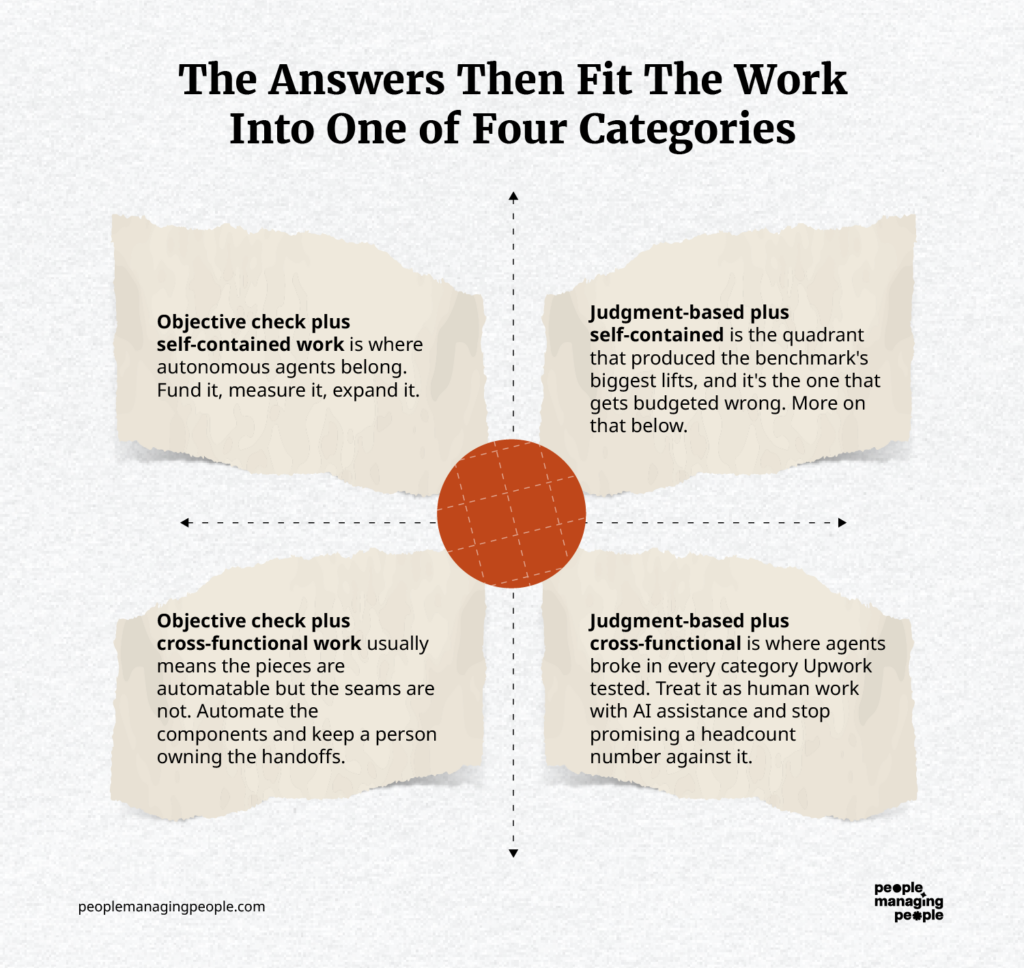
Objektiv kontrol plus selvstændigt arbejde er der, autonome agenter hører hjemme. Finansier det, mål det, udvid det.
Objektiv kontrol plus tværfunktionelt arbejde betyder som regel, at delene kan automatiseres, men at overgangene ikke kan. Automatiser komponenterne, og lad en person eje overleveringerne.
Dømmekraftsbaseret plus selvstændigt er den kvadrant, der gav benchmarkens største løft, og det er den, der får budgetteret forkert. Mere om det nedenfor.
Dømmekraftsbaseret plus tværfunktionelt er der, hvor agenter brød sammen i alle de kategorier, Upwork testede. Betragt det som menneskeligt arbejde med AI-assistance, og hold op med at love et bestemt antal medarbejdere i forhold til det.
Upworks egen økonomiske modellering lander omtrent samme sted. Løsninger med kun agenter vinder på opgaver med lav værdi, hvor omkostningen ved fejl er lille, samarbejde vinder i midten, og fuld menneskelig udførelse vinder på arbejde med høj værdi, hvor et dårligt resultat koster mere, end automatiseringen sparer.
Den opgave, Upwork valgte at vise
HAPI-siden indeholder fem eksempelopgaver med leverancer, du kan downloade. Den ene er en opgave inden for leadgenerering. Filtrér et regneark med mobilapps ned til dem, der har hovedkvarter i USA, find to til fire marketingkontakter hos hver, og udfyld ni navngivne kolonner.
Objektivt kontrollerbart. Én funktion, ét format. Kriterierne i vurderingsskemaet er synlige på siden, og ingen af dem kræver personlig smag.
Begge leverancer blev vurderet som ikke-beståede. Agenten, der arbejdede alene, bestod ikke. Det gjorde agenten, der arbejdede sammen med en ekspert, heller ikke, selv om en freelancer vejledte den.
Upwork offentliggjorde det på deres egen marketingside sammen med en påstand om, at samarbejde kan øge gennemførelsen med op til 70 %. Giv virksomheden kredit for åbenheden, og tag derefter ved lære af det, for den opgave minder meget om arbejde, som virksomheder allerede overlader til en agent.
Den rigtige person i kredsløbet?
Alle leverandørpræsentationer sælger mennesket i kredsløbet som en sikkerhedsfunktion. Læs vurderingskriterierne, og et andet spørgsmål trænger sig på.
Upworks bedømmere havde alle en Job Success Score på 100 % samt status som Topbedømt eller Topbedømt Plus. Tilsammen havde de tjent over 1 million dollars på platformen gennem mere end 96.000 timer.
Det er toppen af en global talentmarkedsplads. Det er også den eneste gruppe af bedømmere, der blev testet. Artiklen bemærker, at teamet ikke kortlagde bedømmernes ekspertise eller undersøgte, hvordan en bedømmers baggrund ændrer værdien af deres feedback. Der var ingen betingelse med en juniorbedømmer.
Så alle tal i undersøgelsen beskriver det bedst mulige tilfælde for menneskeligt tilsyn, og effekten af at bemande rollen med den, der havde kapacitet, er ikke blevet målt af nogen.
Det er mit argument snarere end sammenligningsmålingens, og det har to konsekvenser, som de fleste arbejdsstyrkeplaner ikke har indregnet.
Den første er, at gennemgang er produktionskapacitet, ikke faste omkostninger. I den vurderingsbaserede kvadrant er eksperten ikke et kontrolpunkt, der er føjet til en automatiseret proces. Eksperten er det input, der forvandler et udkast til noget, der kan leveres, og den firedobbelte tidsforskel mellem de to betingelser er prisen for dette input.
Hvis du klassificerer det som tilsyn, undervurderer du arbejdsgangen, samtidig med at du overvurderer besparelserne. Den beregning, der retfærdiggjorde investeringen, beskriver ikke længere den proces, du faktisk har bygget.
Den anden konsekvens er langsommere og værre. Hver plan, der udtynder roller på mellemniveau for at finansiere AI-udgifter, reducerer også den gruppe, der om tre år bliver senior nok til at tilsidesætte en model.
Ekspertvurdering er ikke et kvalifikationsbevis, men en rest. Den ophobes gennem udførelsen af arbejdet, i begyndelsen på en dårlig måde, mens en mere erfaren person retter dig. Automatisér de nederste trin, og du beholder nutidens bedømmere, samtidig med at du fjerner den mekanisme, der skaber morgendagens.
Det er et ledelsesproblem, før det er et bemandingsproblem, og det hører til hos den, der underskriver businesscasen for automatiseringen.
Hvis agenter bliver købere, er dømmekraften produktet
Rabinovichs vurdering af, hvor dette marked bevæger sig hen, er, at agenter bliver en kilde til efterspørgsel snarere end kun en kilde til udbud. En model, der arbejder sig gennem en opgave, den ikke kan verificere – et medicinsk spørgsmål, en restaurantanbefaling eller noget som helst, der hviler på smag – hyrer et menneske i realtid til at kontrollere den. Mennesket leverer ikke projektet, men validerer blot resultatet.
Det er en platformchef, der beskriver sin egen virksomheds potentiale, og det bør vurderes som sådan.
Konsekvensen for arbejdsstyrken består, uanset om mekanismen kommer til udtryk på den måde. Hvis verifikation er menneskets varige bidrag, defineres de værdifulde roller af dømmekraften omkring resultatkvaliteten snarere end af produktionsmængden.
Disse roller er i øjeblikket spredt på tværs af anciennitetsniveauer, jobfamilier og omkostningscentre, som ofte ikke er kortlagt, hvilket betyder, at de fleste organisationer ikke kan sige, hvem de er, eller hvad det vil koste at erstatte dem.
Fire tiltag
Så hvad kan du gøre for at vurdere, om du er klar til at begynde at overlade ting til agenter, så de kan færdiggøre i det mindste noget af arbejdet?
- Hent ti resultater fra din mest automatiserede arbejdsgang og læg dem foran den, der tidligere ejede arbejdet. Spørg, hvor mange vedkommende ville have sendt til en kunde uden ændringer. Det tal er din reelle automatiseringsgrad.
- Navngiv for hver automatiseret arbejdsgang den person, der har beføjelse til at afvise resultatet. Undersøg derefter, om personen kan udøve denne beføjelse uden at eskalere sagen.
- Omklassificér gennemgangstiden i arbejdsgange, der falder i den vurderingsbaserede kvadrant. Flyt den fra tilsyn til produktion, og genberegn businesscasen.
- Læs dine leverandørkontrakter for at se, hvad gennemførelse betyder. Accept, der vurderes efter ét kriterium, og "opgave forsøgt" er forskellige påstande, og kun én af dem er det, sammenligningsmålingen målte.

