
Wat je agenten niet zonder jou kunnen afronden
Kernverschuiving: Upwork verkoopt nu werkoplevering, waarbij systemen mensen en machines combineren om resultaten te behalen in plaats van functies te vervullen.
Grenzen van de benchmark: De automatiseringsbenchmark van Upwork testte geselecteerde taken met een lage complexiteit, waardoor de resultaten niet representatief zijn voor het meeste werk op het platform.
Menselijke waarde: Menselijke feedback verbeterde de voltooiing door agenten, maar vereiste aanzienlijk meer tijd en leidde nooit tot betrouwbaar succes bij alle taken.
Verificatiekloof: Automatisering werkt het best wanneer resultaten objectief kunnen worden gecontroleerd; werk dat veel oordeelsvermogen en samenwerking tussen functies vereist, heeft nog steeds verantwoordelijke menselijke aansturing nodig.
Zakelijke test: Meet automatisering aan de hand van geaccepteerde resultaten, prijs deskundige beoordeling als productie en bescherm functies op middenniveau die toekomstig oordeelsvermogen ontwikkelen.
Upwork noemt zichzelf niet langer een talentenmarktplaats. Nu is de term “platform voor werkuitvoering”, en de verschuiving gaat verder dan alleen positionering.
Op een marktplaats huurt een klant een persoon in. Op een platform voor werkuitvoering beschrijft een klant een resultaat en bepaalt het systeem welke combinatie van mensen en machines dat resultaat oplevert.
Andrew Rabinovich, die bij Upwork leiding geeft aan AI, beschrijft de eenheid die wordt gekocht als iets dat kleiner is dan een baan en kleiner dan een functie. Twee decennia aan platformgegevens, zo zei hij tijdens AI4, suggereren dat de enorme verscheidenheid aan werk die op Upwork wordt geplaatst uiteenvalt in ongeveer 500 tot 1.000 terugkerende taken. Hij noemt ze "atomaire werkeenheden", basisfuncties die opnieuw kunnen worden gecombineerd tot elke opdracht die een klant zou kunnen plaatsen.
Een bedrijf dat van plan is opgesplitst werk te verkopen, neemt een verplichting op zich. Het moet weten welke opgesplitste onderdelen een machine zelfstandig kan afronden, en het moet dat nauwkeurig genoeg weten om geld achter het antwoord te zetten.
Upwork voerde daarom echte klantopdrachten uit via een benchmark, publiceerde de resultaten als de Productiviteitsindex voor mens + agent en documenteerde de methodologie in een paper die in december via arXiv werd uitgebracht.
De belangrijkste bevinding is wat de agents afmaakten. De nuttigere bevinding is wat het kost om hen het af te laten maken, en wie uiteindelijk die kosten draagt.
Werk dat zich het best leent voor automatisering
De methodologie verdient meer aandacht dan de resultaten, omdat zij het plafond bepaalt van wat de resultaten kunnen betekenen.
Upwork selecteerde 322 echte opdrachten die al door betalende klanten waren geplaatst en door menselijke freelancers waren voltooid en door de klant geaccepteerd. Deskundige freelancers schreven voor elke opdracht een beoordelingskader met tussen de 5 en 20 acceptatiecriteria, ingedeeld als kritiek, belangrijk, optioneel en valkuil. Een opdracht telde alleen als voltooid als aan elk kritiek en belangrijk criterium was voldaan.
Drie modellen voerden het werk uit: Claude, Gemini en GPT-5.
Bij de selectiecriteria moet een leidinggevende beter opletten. De opdrachten waren beperkt tot contracten met een vaste prijs, één mijlpaal en een duidelijk afgebakende scope. De looptijd varieerde van negen uur tot meer dan 100 dagen, dus dit waren niet allemaal microtaken. Werk met een open einde en complex werk werden uitgesloten met als opgegeven reden dat agents daarop geen redelijke kans maakten.
Upwork beschrijft die uitgesloten categorie als veruit het grootste deel van wat er op het platform gebeurt.
Voor iedereen die de resultaten meteen wil afwijzen, is nog een beperking van belang. De agents werden bewust eenvoudig gehouden. Elke agent las de opdracht en eventuele bijlagen, maakte een plan, produceerde een resultaat en stopte. Geen zoekopdrachten op internet, geen toegang tot externe gegevens, geen aanvullende hulpmiddelen en geen training op het taaktype.
Daarom merken de auteurs op dat de bevindingen niet representatief zijn voor systemen met veel hulpmiddelen en beschrijven zij hun eigen cijfers als conservatieve schattingen.
Elk cijfer hieronder is dus gemeten op het eenvoudigste beschikbare werk, nadat de moeilijke gevallen vooraf waren verwijderd, met agents die waren ontdaan van de hulpmiddelen die de meeste bedrijven daadwerkelijk inzetten.
Administratieve ondersteuning is moeilijker dan het lijkt
Alleen werkend voldeden de agents aan elk criterium bij ergens tussen 4 en 68% van de opdrachten, afhankelijk van de categorie en het model. Web- en softwareontwikkeling stonden bovenaan. Datawetenschap volgde op korte afstand.
Administratieve ondersteuning eindigde gemiddeld over de drie modellen als laatste, met bij twee ervan een score van 6%.
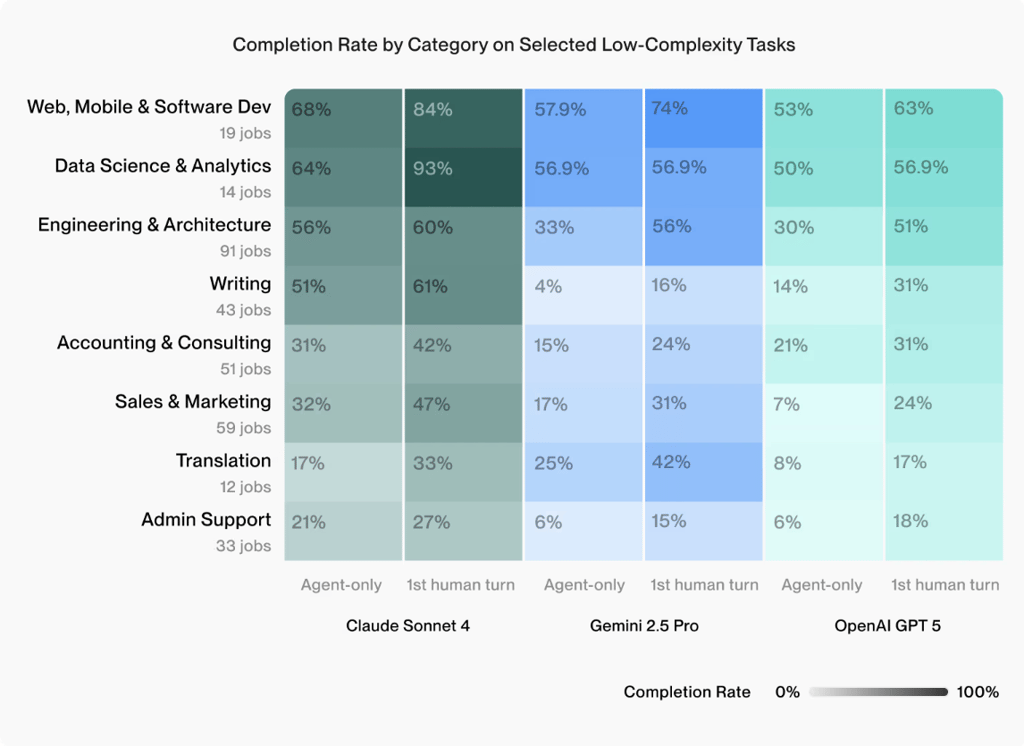
Die volgorde staat haaks op de manier waarop de meeste automatiseringsroadmaps worden opgebouwd. Administratief werk wordt als eerste aangepakt, vanuit de redelijk klinkende aanname dat het het eenvoudigste werk in het gebouw is.
De benchmark suggereert dat eenvoudig te beschrijven en eenvoudig te verifiëren afzonderlijke eigenschappen zijn, en dat alleen de tweede voorspelt of een agent de opdracht kan afronden.
Rabinovichs eigen framing laat zien hoe gemakkelijk die aanname ontstaat. Toen hem werd gevraagd naar het effect op freelancers, beschreef hij werk op laag niveau, zoals logo's maken en samenvattingen van zaken schrijven, als werk dat al volledig is geautomatiseerd. De benchmark van zijn bedrijf gaf schrijven, afhankelijk van het model, een score tussen 4% en 51%, waarbij Gemini onderaan dat bereik zat. De intuïtie en de meting wijzen in verschillende richtingen.
Een ronde feedback van deskundigen verhoogde de algehele voltooiing voor elk model. Claude ging bij taken met een lage complexiteit van 39,8% naar 51,2% na slechts één menselijke interventie. Gemini ging van 19,9% naar 32,3%. GPT-5 ging van 19,6% naar 33,5%. In absolute termen betekent dat een verbetering van 11 tot 14 procentpunten door één enkele menselijke betrokkenheid.

Upwork positioneert de bovenkant van de relatieve bandbreedte als een stijging tot 70%, wat rekenkundig klopt op basis van de lage uitgangswaarde van GPT-5 en samen met de absolute cijfers moet worden gelezen.
De beweging op categorieniveau was ongelijkmatig. Claude's voltooiingspercentage voor datawetenschap ging van 64% naar 93%. Gemini's schrijfwerk ging van 4% naar 16%. Gemini's prestaties op het gebied van datawetenschap veranderden helemaal niet.
Niets bereikte 100%. Zelfs niet bij het eenvoudigste beschikbare werk, met een expert die het begeleidde.
Verificatie is het deel dat we niet hebben opgelost
Rabinovich schat het kwalitatieve aandeel van het werk op het platform op meer dan 90% en is duidelijk over wat dat betekent voor evaluatie. Deterministisch werk heeft zijn eigen controle. Een vertaling kan door een ander model worden gecontroleerd. Code compileert en doorstaat tests, of niet. Voor al het overige is de enige beschikbare verificatie een persoon met beoordelingsvermogen die de uitvoer bekijkt en beslist of die goed genoeg is.
Hij omschreef dit als grotendeels onopgelost en ging nog verder.
Los betrouwbare validatie van kwalitatieve uitvoer op en je hebt AI min of meer opgelost.
De auteurs van het onderzoek zijn zorgvuldig met wat hun eigen cijfers op dit punt bewijzen. Ze voerden geen vergelijkbare tweede pogingen uitsluitend door agents uit op de opdrachten die waren mislukt. Daardoor kan de verbetering niet worden losgekoppeld van het effect van het model simpelweg opnieuw laten proberen. Dat is hun toelichting, opgenomen bij de beperkingen van het onderzoek.
Wat de benchmark aantoont, is beperkter dan de formulering van Upwork suggereert. Een tweede poging na feedback van een expert presteert beter dan een eerste poging. Hoeveel daarvan aan de feedback en hoeveel aan de nieuwe poging moet worden toegeschreven, is niet gemeten.
Het plafond is de blijvende bevinding. Onder omstandigheden die waren geselecteerd voor succes van de agent, werd ongeveer één op de vijf aanvankelijk mislukte opdrachten gered door een tweede, door een mens begeleide poging, en kwam de voltooiing voor het sterkste model uit op maximaal 51%. De door mensen begeleide uitvoeringen duurden ook ongeveer vier keer zo lang: 14,5 minuten tegenover 3,6.
Upworks eigen productbeslissing wijst in dezelfde richting. UMA, het vlaggenschip-AI-systeem van het bedrijf, werd gebouwd als orkestratieagent in plaats van als uitvoerder. Het interpreteert de bedoeling, splitst die op, stuurt onderdelen naar mensen of machines en controleert het resultaat. Het voert de taak niet uit.
Een bedrijf dat alle commerciële prikkels heeft om autonome uitvoering te verkopen, ontwierp zijn centrale systeem rond de aanname dat een mens bij het werk betrokken blijft.
Twee vragen voordat je een workflow financiert
Er zijn twee belangrijke vragen die je moet stellen over wat je agents wilt laten doen.
Kan de uitvoer aan iets objectiefs worden getoetst? Een testsuite, een aansluiting, een nalevingsregel, een getal dat wel of niet overeenkomt.
Blijft het werk binnen één functie en één formaat? Of gaat het van backend naar frontend naar tekst naar merkgoedkeuring voordat iemand kan zeggen dat het klaar is?
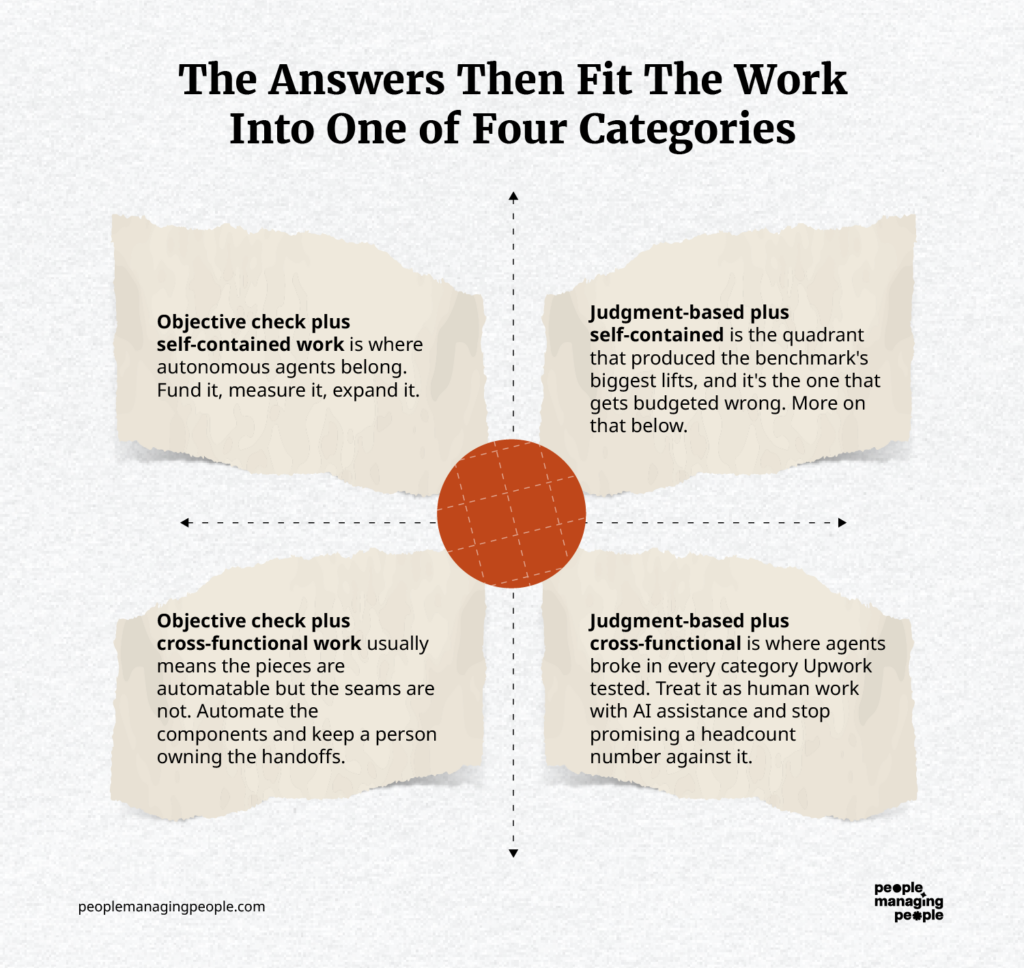
Objectieve controle plus zelfstandig werk is waar autonome agents thuishoren. Financier het, meet het en breid het uit.
Objectieve controle plus cross-functioneel werk betekent meestal dat de onderdelen automatiseerbaar zijn, maar de verbindingen ertussen niet. Automatiseer de componenten en laat één persoon verantwoordelijk blijven voor de overdrachten.
Op beoordeling gebaseerd plus zelfstandig is het kwadrant dat de grootste verbeteringen in de benchmark opleverde en ook het kwadrant dat verkeerd wordt begroot. Daarover hieronder meer.
Op beoordeling gebaseerd plus cross-functioneel is waar agents in elke door Upwork geteste categorie tekortschoten. Behandel dit als mensenwerk met AI-ondersteuning en stop met het beloven van een aantal arbeidsplaatsen daarvoor.
Upworks eigen economische modellering komt ongeveer op hetzelfde neer. Alleen agents winnen bij taken met een lage waarde, waarbij de kosten van fouten klein zijn; samenwerking wint in het middensegment; en volledige menselijke uitvoering wint bij werk met een hoge waarde, waarbij een slecht resultaat meer kost dan de automatisering bespaart.
De opdracht die Upwork koos om te laten zien
De HAPI-pagina bevat vijf voorbeeldopdrachten met resultaten die je kunt downloaden. Een daarvan is een taak voor leadgeneratie. Filter een spreadsheet met mobiele apps zodat alleen de apps met hoofdkantoor in de VS overblijven, zoek per app twee tot vier marketingcontacten en vul negen benoemde kolommen in.
Objectief controleerbaar. Eén functie, één format. De beoordelingscriteria zijn zichtbaar op de pagina en geen ervan vereist smaak.
Beide opleveringen werden afgewezen bij de evaluatie. De agent die alleen werkte faalde. Ook de freelancer die de agent die met een expert werkte begeleidde, faalde.
Upwork zette dat op zijn eigen marketingpagina, naast een claim dat samenwerking de voltooiing met maximaal 70% verhoogt. Geef het bedrijf erkenning voor de openheid en trek vervolgens de les, want die opdracht komt sterk overeen met werk dat bedrijven al aan een agent toevertrouwen.
De juiste persoon in de lus?
Elke leverancierspresentatie verkoopt de mens in de lus als veiligheidsfunctie. Lees de criteria van de beoordelaars en er komt een andere vraag naar voren.
Alle beoordelaars van Upwork hadden een Job Success Score van 100% en de status Top Rated of Top Rated Plus. Gezamenlijk hadden ze op het platform meer dan $1 miljoen verdiend, verspreid over meer dan 96.000 uur.
Dat is de top van een mondiale talentmarktplaats. Het is ook de enige populatie beoordelaars die is getest. In het artikel staat dat het team de deskundigheid van de beoordelaars niet heeft geprofileerd en niet heeft onderzocht hoe de achtergrond van een beoordelaar de waarde van diens feedback beïnvloedt. Er was geen conditie met junioren.
Elk getal in het onderzoek beschrijft dus een bestcasescenario voor menselijk toezicht, terwijl het effect van het invullen van die rol door iemand die toevallig capaciteit had, door niemand is gemeten.
Dat is mijn argument en niet dat van de benchmark, en het heeft twee gevolgen waar de meeste personeelsplannen geen prijskaartje aan hebben gehangen.
Het eerste is dat beoordeling productiecapaciteit is, geen overhead. In het kwadrant waarin oordeel centraal staat, is de expert geen controlepunt dat aan een geautomatiseerd proces is vastgeschroefd. De expert is de input die een concept omzet in iets dat kan worden opgeleverd, en het viervoudige tijdsverschil tussen de twee condities zijn de kosten van die input.
Classificeer dit als toezicht en je onderschat de workflow terwijl je de besparingen overschat. De berekening die de investering rechtvaardigde, beschrijft dan niet langer het proces dat je daadwerkelijk hebt gebouwd.
Het tweede gevolg is trager en erger. Elk plan dat functies op middenniveau uitdunt om AI-uitgaven te financieren, verkleint ook de groep die over drie jaar senior genoeg is om een model terzijde te schuiven.
Deskundig oordeel is geen certificaat, maar bezinksel. Het stapelt zich op door het werk te doen, aanvankelijk slecht, terwijl iemand met meer ervaring je corrigeert. Automatiseer de onderste treden en je behoudt de beoordelaars van vandaag, maar verwijdert het mechanisme dat die van morgen voortbrengt.
Dat is eerst een leiderschapsprobleem en pas daarna een personeelsprobleem, en het ligt bij degene die de onderbouwing voor de automatisering ondertekent.
Als agenten kopers worden, is oordeel het product
Rabinovichs visie op de volgende fase van deze markt is dat agenten een bron van vraag worden in plaats van alleen een bron van aanbod. Een model dat een taak uitvoert die het niet kan verifiëren — een medische vraag, een restaurantaanbeveling of iets anders dat op smaak berust — huurt in real time een mens in om het te controleren. De mens levert het project niet op, maar valideert simpelweg de uitvoer.
Dat is een leidinggevende van een platform die de opwaartse mogelijkheden van zijn eigen bedrijf beschrijft, en het moet als zodanig worden gewogen.
De gevolgen voor de beroepsbevolking blijven overeind, ongeacht of het mechanisme in die vorm verschijnt. Als verificatie de blijvende menselijke bijdrage is, worden de waardevolle functies bepaald door het oordeel over de kwaliteit van de uitvoer en niet door productievolume.
Die functies zijn momenteel verspreid over verschillende senioriteitsniveaus, functiefamilies en kostenplaatsen die vaak niet in kaart zijn gebracht. Daardoor kunnen de meeste organisaties niet zeggen om wie het gaat of wat het zou kosten om hen te vervangen.
Vier stappen
Wat kun je dus doen om te beoordelen of je klaar bent om agenten ten minste een deel van het werk te laten overnemen?
- Haal tien uitvoerresultaten uit je meest geautomatiseerde workflow en leg ze voor aan degene die dat werk vroeger beheerde. Vraag hoeveel daarvan zij ongewijzigd naar een klant zouden hebben gestuurd. Dat getal is je echte automatiseringspercentage.
- Wijs voor elke geautomatiseerde workflow de persoon aan die bevoegd is om de uitvoer af te wijzen. Controleer vervolgens of die persoon die bevoegdheid kan uitoefenen zonder naar een hoger niveau te escaleren.
- Classificeer de beoordelingstijd opnieuw in workflows die in het oordeelskwadrant vallen. Verplaats die tijd van toezicht naar productie en herbereken de businesscase.
- Lees in je leverancierscontracten na wat voltooiing betekent. Acceptatie op basis van een rubric waarbij elk criterium wordt beoordeeld en "taak geprobeerd" zijn verschillende beweringen, en slechts één daarvan is wat de benchmark heeft gemeten.


